

Dietro le quinte: la MessageQueue senza blocchi di Android 17
Tempo di lettura: 16 min


In Android 17, le app che hanno come target l'SDK 37 o versioni successive riceveranno una nuova implementazione di MessageQueue in cui l'implementazione è senza blocco. La nuova implementazione migliora le prestazioni e riduce i frame persi, ma potrebbe interrompere i client che riflettono su campi e metodi privati di MessageQueue. Per scoprire di più sulla modifica del comportamento e su come puoi attenuarne l'impatto, consulta la documentazione sulla modifica del comportamento di MessageQueue. Questo blog post tecnico fornisce una panoramica della riprogettazione dell'architettura di MessageQueue e di come puoi analizzare i problemi di conflitto di blocco utilizzando Perfetto.
Il Looper gestisce il thread dell'interfaccia utente di ogni app per Android. Estrae il lavoro da una MessageQueue, lo invia a un Handler e ripete l'operazione. Per vent'anni, MessageQueue ha utilizzato un unico blocco monitor (ovvero un blocco di codice synchronized) per proteggere il suo stato.
Android 17 introduce un aggiornamento significativo di questo componente: un'implementazione senza blocchi denominata DeliQueue.
Questo post spiega in che modo i blocchi influiscono sulle prestazioni della UI, come analizzare questi problemi con Perfetto e gli algoritmi e le ottimizzazioni specifici utilizzati per migliorare il thread principale di Android.
Il problema: conflitto di blocchi e inversione di priorità
La versione precedente di MessageQueue funzionava come una coda con priorità protetta da un unico blocco. Se un thread in background pubblica un messaggio mentre il thread principale esegue la manutenzione della coda, il thread in background blocca il thread principale.
Quando due o più thread competono per l'uso esclusivo dello stesso blocco, si parla di concorrenza di blocco. Questo conflitto può causare l'inversione di priorità, con conseguenti problemi di jank della UI e altri problemi di prestazioni.
L'inversione della priorità può verificarsi quando un thread ad alta priorità (come il thread dell'interfaccia utente) viene fatto attendere per un thread a bassa priorità. Considera questa sequenza:
- Un thread in background con priorità bassa acquisisce il blocco
MessageQueueper pubblicare il risultato del lavoro svolto. - Un thread con priorità media diventa eseguibile e lo scheduler del kernel gli assegna il tempo di CPU, sostituendo il thread con priorità bassa.
- Il thread dell'interfaccia utente con priorità alta termina l'attività corrente e tenta di leggere dalla coda, ma viene bloccato perché il thread con priorità bassa detiene il blocco.
Il thread a bassa priorità blocca il thread dell'interfaccia utente e il lavoro a priorità media lo ritarda ulteriormente.

Analisi della contesa con Perfetto
Puoi diagnosticare questi problemi utilizzando Perfetto. In una traccia standard, un thread bloccato su un blocco del monitor entra nello stato di sospensione e Perfetto mostra una sezione che indica il proprietario del blocco.
Quando esegui query sui dati di traccia, cerca le sezioni denominate "monitor contention with…" seguite dal nome del thread proprietario del blocco e dal sito del codice in cui è stato acquisito il blocco.
Case study: jank di Avvio app
Per illustrare questo concetto, analizziamo una traccia in cui un utente ha riscontrato un jank durante la navigazione verso la schermata Home su uno smartphone Pixel subito dopo aver scattato una foto nell'app Fotocamera. Di seguito è riportato uno screenshot di Perfetto che mostra gli eventi che hanno portato al frame mancato:

- Sintomo: il thread principale di Avvio app non ha rispettato la scadenza del frame. È stato bloccato per 18 ms, superando la scadenza di 16 ms richiesta per il rendering a 60 Hz.
- Diagnosi: Perfetto ha mostrato che il thread principale era bloccato sul blocco
MessageQueue. Un thread "BackgroundExecutor" era proprietario del blocco. - Causa principale: BackgroundExecutor viene eseguito con Process.THREAD_PRIORITY_BACKGROUND (priorità molto bassa). Ha eseguito un'attività non urgente (controllo dei limiti di utilizzo delle app). Contemporaneamente, i thread con priorità media utilizzavano il tempo di CPU per elaborare i dati della videocamera. Lo scheduler del sistema operativo ha prerilasciato il thread BackgroundExecutor per eseguire i thread della fotocamera.
Questa sequenza ha causato il blocco indiretto del thread dell'interfaccia utente di Avvio app (priorità alta) da parte del thread di lavoro della fotocamera (priorità media), che impediva al thread in background di Avvio app (priorità bassa) di rilasciare il blocco.
Esecuzione di query sulle tracce con PerfettoSQL
Puoi utilizzare PerfettoSQL per eseguire query sui dati di traccia per pattern specifici. Questa opzione è utile se hai un gran numero di tracce provenienti da dispositivi o test degli utenti e stai cercando tracce specifiche che mostrano un problema.
Ad esempio, questa query trova la contesa di MessageQueue in concomitanza con i frame persi (jank):
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
In questo esempio più complesso, unisci i dati di traccia che si estendono su più tabelle per identificare la contesa di MessageQueue durante l'avvio dell'app:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
Puoi utilizzare il tuo LLM preferito per scrivere query PerfettoSQL per trovare altri pattern.
In Google, utilizziamo BigTrace per eseguire query PerfettoSQL su milioni di tracce. In questo modo, abbiamo confermato che ciò che avevamo osservato in modo aneddotico era, in realtà, un problema sistemico. I dati hanno rivelato che la contesa dei blocchi di MessageQueue interessa gli utenti di tutto l'ecosistema, confermando la necessità di un cambiamento fondamentale dell'architettura.
Soluzione: contemporaneità senza blocchi
Abbiamo risolto il problema di conflitto di MessageQueue implementando una struttura dei dati senza blocchi, utilizzando operazioni di memoria atomica anziché blocchi esclusivi per sincronizzare l'accesso allo stato condiviso. Una struttura di dati o un algoritmo è senza blocchi se almeno un thread può sempre progredire indipendentemente dal comportamento di pianificazione degli altri thread. Questa proprietà è generalmente difficile da ottenere e di solito non vale la pena perseguirla per la maggior parte del codice.
Primitive atomiche
Il software senza blocchi spesso si basa su primitive atomiche di lettura-modifica-scrittura fornite dall'hardware.
Sulle CPU ARM64 di generazione precedente, le operazioni atomiche utilizzavano un loop Load-Link/Store-Conditional (LL/SC). La CPU carica un valore e contrassegna l'indirizzo. Se un altro thread scrive in quell'indirizzo, l'archiviazione non riesce e il loop riprova. Poiché i thread possono continuare a riprovare e avere esito positivo senza attendere un altro thread, questa operazione è senza blocchi.
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retr(visualizza in Compiler Explorer)
Le architetture ARM più recenti (ARMv8.1) supportano le Large System Extensions (LSE), che includono istruzioni sotto forma di Compare-And-Swap (CAS) o Load-And-Add (illustrate di seguito). In Android 17 abbiamo aggiunto il supporto al compilatore Android Runtime (ART) per rilevare quando LSE è supportato ed emettere istruzioni ottimizzate:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
Nei nostri benchmark, il codice ad alta contesa che utilizza CAS ottiene un'accelerazione di circa 3 volte rispetto alla variante LL/SC.
Il linguaggio di programmazione Java offre primitive atomiche tramite java.util.concurrent.atomic che si basano su queste e altre istruzioni CPU specializzate.
La struttura dei dati: DeliQueue
Per rimuovere la contesa dei blocchi da MessageQueue, i nostri ingegneri hanno progettato una nuova struttura di dati chiamata DeliQueue. DeliQueue separa l'inserimento di Message dall'elaborazione di Message:
- L'elenco di
Messages(Treiber stack): uno stack senza blocchi. Qualsiasi thread può eseguire il push di nuoviMessagesqui senza conflitti. - La coda con priorità (Min-heap): un heap di
Messagesda gestire, di proprietà esclusiva del thread Looper (pertanto non sono necessarie sincronizzazioni o blocchi per l'accesso).
Enqueue: pushing to a Treiber stack
L'elenco di Messages viene conservato in uno stack Treiber [1], uno stack senza blocchi che utilizza un loop CAS per aggiornare il puntatore head.
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
Codice sorgente basato su Java Concurrency in Practice [2], disponibile online e rilasciato nel dominio pubblico
Qualsiasi producer può eseguire il push di nuovi Message nello stack in qualsiasi momento. È come prendere un biglietto al banco di una gastronomia: il tuo numero è determinato dal momento in cui ti sei presentato, ma l'ordine in cui ricevi il cibo non deve necessariamente corrispondere. Poiché si tratta di uno stack collegato, ogni Message è un sottostack: puoi vedere com'era la coda Message in qualsiasi momento monitorando l'intestazione e ripetendo l'iterazione in avanti. Non vedrai nuovi Message aggiunti in cima, anche se vengono aggiunti durante l'attraversamento.
Dequeue: bulk transfer to a min-heap
Per trovare il prossimo Message da gestire, il Looper elabora i nuovi Message dallo stack Treiber scorrendo lo stack dall'alto e ripetendo l'operazione fino a trovare l'ultimo Message che ha elaborato in precedenza. Man mano che Looper attraversa lo stack, inserisce Message nel min-heap ordinato in base alla scadenza. Poiché l'Looper possiede esclusivamente l'heap, ordina ed elabora i Message senza blocchi o atomici.
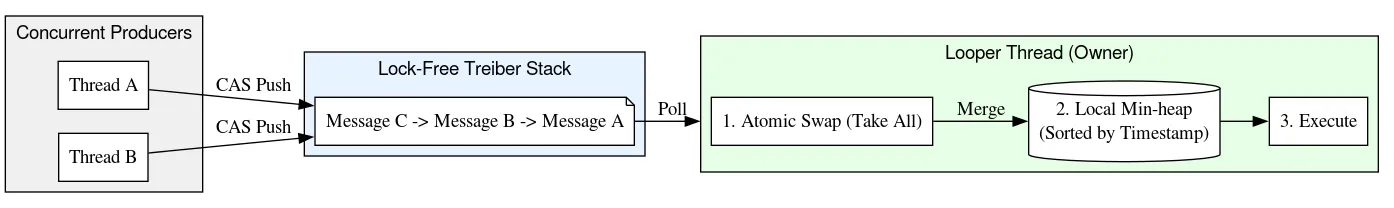
Durante l'analisi dello stack, Looper crea anche collegamenti dagli Message impilati ai loro predecessori, formando così un elenco con doppio collegamento. La creazione dell'elenco collegato è sicura perché i link che puntano verso il basso nello stack vengono aggiunti tramite l'algoritmo dello stack Treiber con CAS, mentre i link che puntano verso l'alto nello stack vengono letti e modificati solo dal thread Looper. Questi link di ritorno vengono poi utilizzati per rimuovere Message da punti arbitrari dello stack in un tempo O(1).
Questo design fornisce un inserimento O(1) per i producer (thread che pubblicano il lavoro nella coda) e un'elaborazione O(log N) ammortizzata per il consumer (Looper).
L'utilizzo di un min-heap per ordinare i Message risolve anche un difetto fondamentale del MessageQueue precedente, in cui i Message venivano conservati in un elenco collegato singolarmente (con root in alto). Nell'implementazione precedente, la rimozione dalla testa era O(1), ma l'inserimento aveva un caso peggiore di O(N), con una scalabilità scarsa per le code sovraccariche. Al contrario, l'inserimento e la rimozione dal min-heap scalano in modo logaritmico, offrendo prestazioni medie competitive, ma eccellendo davvero nelle latenze di coda.
Legacy (bloccato) MessageQueue | DeliQueue | |
| Inserisci | O(N) | O(1) per il thread di chiamata O(logN) per il thread |
| Rimuovi dalla testa | O(1) | O(logN) |
Nell'implementazione della coda legacy, i producer e il consumer utilizzavano un blocco per coordinare l'accesso esclusivo alla lista concatenata singola sottostante. In DeliQueue, lo stack Treiber gestisce l'accesso simultaneo e il singolo consumer gestisce l'ordinamento della coda di lavoro.
Rimozione: coerenza tramite tombstone
DeliQueue è una struttura di dati ibrida che unisce uno stack Treiber senza blocchi con un min-heap single-thread. Mantenere sincronizzate queste due strutture senza un blocco globale presenta una sfida unica: un messaggio potrebbe essere fisicamente presente nello stack, ma rimosso logicamente dalla coda.
Per risolvere questo problema, DeliQueue utilizza una tecnica chiamata "tombstoning". Ogni Message tiene traccia della sua posizione nello stack tramite i puntatori avanti e indietro, il suo indice nell'array dell'heap e un flag booleano che indica se è stato rimosso. Quando un Message è pronto per l'esecuzione, il thread Looper esegue il CAS del flag rimosso, quindi lo rimuove dall'heap e dallo stack.
Quando un altro thread deve rimuovere un Message, non lo estrae immediatamente dalla struttura dei dati. Esegue, invece, i seguenti passaggi:
- Rimozione logica: il thread utilizza un CAS per impostare in modo atomico il flag di rimozione di
Messageda false a true. LaMessagerimane nella struttura dei dati come prova della sua rimozione in attesa, un cosiddetto "tombstone". Una volta che unaMessageè stata contrassegnata per la rimozione, DeliQueue la tratta come se non esistesse più nella coda ogni volta che viene trovata. - Pulizia differita: la rimozione effettiva dalla struttura dei dati è responsabilità del thread
Loopered è differita a un secondo momento. Anziché modificare lo stack o l'heap, il thread di rimozione aggiungeMessagea un altro stack di freelist senza blocchi. - Rimozione strutturale: solo
Looperpuò interagire con l'heap o rimuovere elementi dallo stack. Quando si riattiva, cancella la freelist ed elabora iMessageche conteneva. OgniMessageviene quindi scollegato dallo stack e rimosso dall'heap.
Questo approccio mantiene tutta la gestione dell'heap in un unico thread. Riduce al minimo il numero di operazioni simultanee e di barriere di memoria necessarie, rendendo il percorso critico più rapido e semplice.
Traversal: benign Java memory model data races
La maggior parte delle API di concorrenza, come Future nella libreria standard di Java o Job e Deferred di Kotlin, include un meccanismo per annullare il lavoro prima che venga completato. Un'istanza di una di queste classi corrisponde 1:1 a un'unità di lavoro sottostante e la chiamata di cancel su un oggetto annulla le operazioni specifiche associate.
I dispositivi Android di oggi hanno CPU multi-core e un generational garbage collector simultaneo. Tuttavia, quando Android è stato sviluppato per la prima volta, era troppo costoso allocare un oggetto per ogni unità di lavoro. Di conseguenza, Handler di Android supporta l'annullamento tramite numerosi overload di removeMessages: anziché rimuovere un Message specifico, rimuove tutti i Message che corrispondono ai criteri specificati. In pratica, ciò richiede l'iterazione di tutti i Message inseriti prima della chiamata di removeMessages e la rimozione di quelli corrispondenti.
Durante l'iterazione in avanti, un thread richiede una sola operazione atomica ordinata per leggere l'intestazione corrente dello stack. Successivamente, vengono utilizzate le letture dei campi ordinari per trovare il Message successivo. Se il thread Looper modifica i campi next durante la rimozione di Message, la scrittura di Looper e la lettura di un altro thread non sono sincronizzate: si tratta di una race condition dei dati. In genere, una race condition è un bug grave che può causare enormi problemi nell'app: leak, loop infiniti, arresti anomali, blocchi e altro ancora. Tuttavia, in determinate condizioni limitate, le race condition dei dati possono essere innocue all'interno del Java Memory Model. Supponiamo di iniziare con uno stack di:

Eseguiamo una lettura atomica della testa e vediamo A. Il puntatore next di A punta a B. Mentre elaboriamo B, il looper potrebbe rimuovere B e C, aggiornando A in modo che punti a C e poi a D.
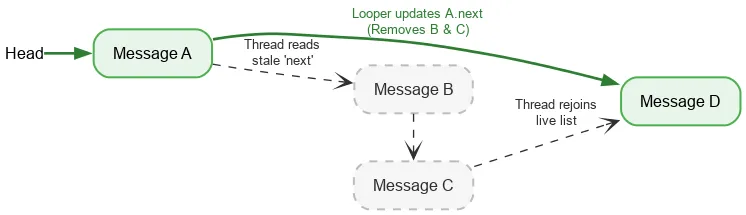
Anche se B e C vengono rimossi logicamente, B mantiene il puntatore successivo a C e C a D. Il thread di lettura continua ad attraversare i nodi rimossi scollegati e alla fine si ricongiunge allo stack attivo in D.
Progettando DeliQueue in modo da gestire le race condition tra l'esplorazione e la rimozione, consentiamo un'iterazione sicura e senza blocchi.
Quitting: Native refcount
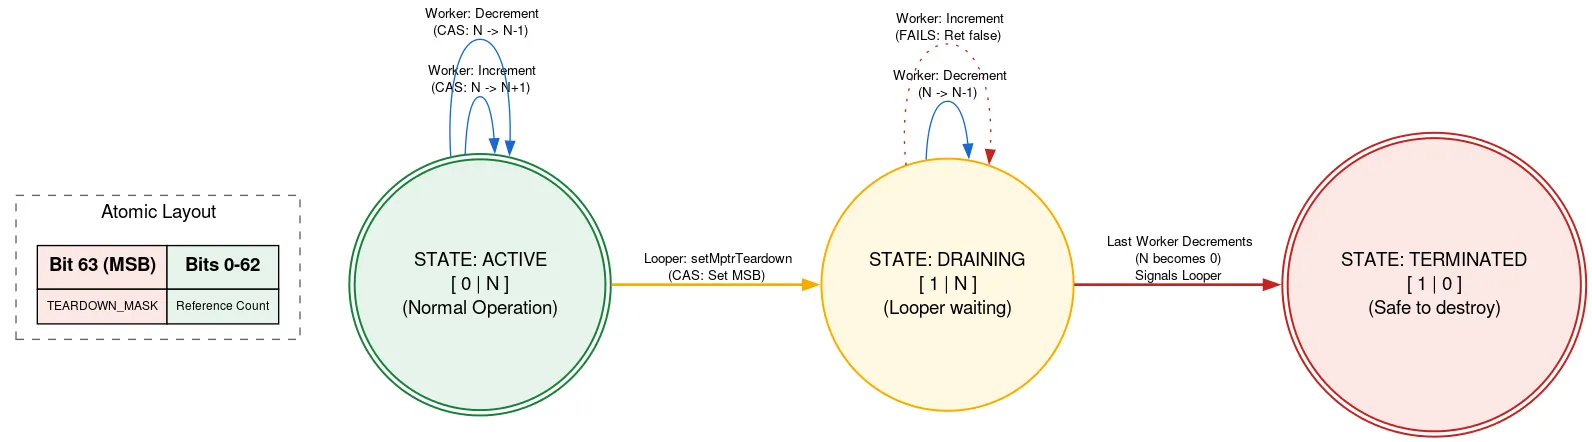
Looper è supportato da un'allocazione nativa che deve essere liberata manualmente dopo l'uscita da Looper. Se un altro thread aggiunge Message mentre Looper sta uscendo, potrebbe utilizzare l'allocazione nativa dopo che è stata liberata, una violazione della sicurezza della memoria. Per evitare questo problema, utilizziamo un refcount con tag, in cui un bit dell'atomico viene utilizzato per indicare se Looper sta uscendo.
Prima di utilizzare l'allocazione nativa, un thread legge il refcount atomico. Se il bit di uscita è impostato, restituisce che Looper sta uscendo e l'allocazione nativa non deve essere utilizzata. In caso contrario, tenta un CAS per incrementare il numero di thread attivi utilizzando l'allocazione nativa. Dopo aver eseguito le operazioni necessarie, decrementa il conteggio. Se il bit di uscita è stato impostato dopo l'incremento, ma prima del decremento, e il conteggio è ora pari a zero, viene attivato il thread Looper.
Quando il thread Looper è pronto per uscire, utilizza CAS per impostare il bit di uscita nell'atomico. Se il refcount era 0, può procedere a liberare la sua allocazione nativa. In caso contrario, si mette in pausa, sapendo che verrà riattivato quando l'ultimo utente dell'allocazione nativa decrementerà il conteggio dei riferimenti. Questo approccio significa che il thread Looper attende l'avanzamento di altri thread, ma solo quando viene chiuso. Questo avviene una sola volta e non è sensibile alle prestazioni, inoltre mantiene l'altro codice per l'utilizzo dell'allocazione nativa completamente privo di blocchi.
L'implementazione presenta molti altri trucchi e complessità. Puoi scoprire di più su DeliQueue esaminando il codice sorgente.
Ottimizzazione: programmazione senza rami
Durante lo sviluppo e il test di DeliQueue, il team ha eseguito molti benchmark e ha profilato attentamente il nuovo codice. Un problema identificato utilizzando lo strumento simpleperf è stato lo svuotamento della pipeline causato dal codice del comparatore Message.
Un comparatore standard utilizza i salti condizionali, con la condizione per decidere quale Message viene prima semplificata di seguito:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
Questo codice viene compilato in salti condizionali (istruzioni b.le e cbnz). Quando la CPU incontra una diramazione condizionale, non può sapere se la diramazione viene eseguita finché non viene calcolata la condizione, quindi non sa quale istruzione leggere successivamente e deve indovinare, utilizzando una tecnica chiamata previsione delle diramazioni. In un caso come la ricerca binaria, la direzione della ramificazione sarà imprevedibilmente diversa a ogni passaggio, quindi è probabile che metà delle previsioni sia errata. La previsione dei rami è spesso inefficace negli algoritmi di ricerca e ordinamento (come quello utilizzato in un min-heap), perché il costo di un'ipotesi errata è maggiore del miglioramento ottenuto con un'ipotesi corretta. Quando il predittore di diramazione sbaglia, deve eliminare il lavoro svolto dopo aver assunto il valore previsto e ricominciare dal percorso effettivamente intrapreso. Questa operazione è chiamata svuotamento della pipeline.
Per trovare questo problema, abbiamo profilato i nostri benchmark utilizzando il contatore delle prestazioni branch-misses, che registra le analisi dello stack in cui il predittore di rami sbaglia. Abbiamo poi visualizzato i risultati con Google pprof, come mostrato di seguito:

Ricorda che il codice MessageQueue originale utilizzava un elenco collegato singolarmente per la coda ordinata. L'inserimento attraverserebbe l'elenco in ordine di ordinamento come una ricerca lineare, fermandosi al primo elemento che si trova oltre il punto di inserimento e collegando il nuovo Message prima di questo. Per rimuovere un nodo dalla testa, è sufficiente scollegarlo. DeliQueue, invece, utilizza un min-heap, in cui le mutazioni richiedono il riordinamento di alcuni elementi (sifting up o down) con complessità logaritmica in una struttura di dati bilanciata, in cui ogni confronto ha la stessa probabilità di indirizzare l'attraversamento a un elemento figlio sinistro o destro. Il nuovo algoritmo è asintoticamente più veloce, ma espone un nuovo collo di bottiglia, poiché il codice di ricerca si blocca per errori di branch la metà delle volte.
Rendendoci conto che i branch miss rallentavano il nostro codice heap, abbiamo ottimizzato il codice utilizzando la programmazione senza branch:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
Per comprendere l'ottimizzazione, disassembla i due esempi in Compiler Explorer e utilizza LLVM-MCA, un simulatore di CPU in grado di generare una cronologia stimata dei cicli della CPU.
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
Tieni presente l'unico ramo condizionale, b.le, che evita di confrontare i campi insertSeq se il risultato è già noto dal confronto dei campi when.
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
In questo caso, l'implementazione senza rami richiede meno cicli e istruzioni rispetto al percorso più breve attraverso il codice con rami, quindi è migliore in tutti i casi. L'implementazione più rapida e l'eliminazione dei branch con previsioni errate hanno portato a un miglioramento di 5 volte in alcuni dei nostri benchmark.
Tuttavia, questa tecnica non è sempre applicabile. Gli approcci senza rami generalmente richiedono un lavoro che verrà scartato e, se il ramo è prevedibile nella maggior parte dei casi, questo lavoro sprecato può rallentare il codice. Inoltre, la rimozione di un ramo spesso introduce una dipendenza dai dati. Le CPU moderne eseguono più operazioni per ciclo, ma non possono eseguire un'istruzione finché non sono pronti i relativi input di un'istruzione precedente. Al contrario, una CPU può ipotizzare i dati nei rami e lavorare in anticipo se un ramo viene previsto correttamente.
Test e convalida
Convalidare la correttezza degli algoritmi senza blocchi è notoriamente difficile.
Oltre ai test delle unità standard per la convalida continua durante lo sviluppo, abbiamo anche scritto rigorosi stress test per verificare gli invarianti della coda e per tentare di indurre race condition dei dati, se esistenti. Nei nostri laboratori di test, potremmo eseguire milioni di istanze di test su dispositivi emulati e su hardware reale.
Con la strumentazione Java ThreadSanitizer (JTSan), abbiamo potuto utilizzare gli stessi test anche per rilevare alcune race condition dei dati nel nostro codice. JTSan non ha trovato alcuna race condition problematica in DeliQueue, ma, sorprendentemente, ha rilevato due bug di concorrenza nel framework Robolectric, che abbiamo prontamente corretto.
Per migliorare le nostre capacità di debug, abbiamo creato nuovi strumenti di analisi. Di seguito è riportato un esempio che mostra un problema nel codice della piattaforma Android in cui un thread sovraccarica un altro thread con Message, causando un grande backlog, visibile in Perfetto grazie alla funzionalità di strumentazione MessageQueue che abbiamo aggiunto.

Per attivare il tracciamento di MessageQueue nel processo system_server, includi quanto segue nella configurazione di Perfetto:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
Impatto
DeliQueue migliora le prestazioni del sistema e delle app eliminando i blocchi da MessageQueue.
- Benchmark sintetici: gli inserimenti multi-thread in code occupate sono fino a 5000 volte più veloci rispetto alla versione precedente di
MessageQueue, grazie alla concorrenza migliorata (lo stack Treiber) e agli inserimenti più rapidi (il min-heap). - Nelle tracce di Perfetto acquisite dai beta tester interni, abbiamo riscontrato una riduzione del 15% del tempo trascorso dal thread principale dell'app in conflitto di blocco.
- Sui medesimi dispositivi di test, la riduzione della contesa dei blocchi ha portato a miglioramenti significativi dell'esperienza utente, ad esempio:
- -4% di frame persi nelle app.
- -7,7% di frame persi nelle interazioni con la UI di sistema e Avvio app.
- -9,1% del tempo dall'avvio dell'app al primo frame disegnato, al 95° percentile.
Passaggi successivi
DeliQueue verrà implementato nelle app in Android 17. Gli sviluppatori di app devono consultare l'articolo Preparare l'app per il nuovo MessageQueue senza blocco sul blog per sviluppatori Android per scoprire come testare le proprie app.
Riferimenti
[1] Treiber, R.K., 1986. Programmazione dei sistemi: gestione del parallelismo. International Business Machines Incorporated, Thomas J. Watson Research Center.
[2] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., & Lea, D. (2006). Java Concurrency in Practice. Addison-Wesley Professional.
-

 Novità sui prodotti
Dopo oltre un anno di preparazione congiunta con leader del settore, partner regionali, App Distribution e community Android, il 30 settembre le nostre protezioni per gli utenti sono state attivate per gli store aderenti in Brasile, Indonesia, Singapore e Thailandia.
Matthew Forsythe • Tempo di lettura: 2 min -

 Novità sui prodotti
Per offrire queste esperienze ai giocatori e garantire che i tuoi giochi siano perfetti su schermi di qualsiasi dimensione, Google Play sta introducendo nuovi requisiti di qualità per i giochi su schermi di grandi dimensioni.
Aurash Mahbod • Tempo di lettura: 4 min -

 Novità sui prodotti
La release di novembre 2026 di Jetpack Compose è stabile. Questa release porta la versione 1.13 in tutti i moduli principali di Compose (consulta la mappatura completa della BOM), introducendo aggiornamenti a testo, grafica, layout, prestazioni e altro ancora, oltre ad alcune importanti deprecazioni e modifiche del comportamento di cui tenere conto.
Meghan Mehta • Tempo di lettura: 10 min
Ricevi gli ultimi approfondimenti sullo sviluppo Android direttamente nella tua casella di posta ogni settimana.
