


در Android 17، برنامههایی که SDK 37 یا بالاتر را هدف قرار میدهند، پیادهسازی جدیدی از MessageQueue دریافت خواهند کرد که در آن پیادهسازی بدون قفل است. پیادهسازی جدید عملکرد را بهبود میبخشد و فریمهای ازدسترفته را کاهش میدهد، اما ممکن است کارخواههایی را که در فیلدها و روشهای خصوصی MessageQueue منعکس میشوند خراب کند. برای کسب اطلاعات بیشتر درباره تغییر رفتار و نحوه کاهش تأثیر آن، سند تغییر رفتار MessageQueue را بررسی کنید. این پست وبلاگ فنی نمای کلی از بازمعماری MessageQueue و نحوه تجزیهوتحلیل مشکلات رقابت قفل بااستفاده از Perfetto را ارائه میدهد.
Looper رشته میانای کاربر هر برنامه Android را هدایت میکند. این حلقه کار را از MessageQueue میکشد، آن را به Handler ارسال میکند، و تکرار میکند. برای دو دهه، MessageQueue از یک قفل نمایشگر واحد (یعنی یک synchronized بلوک کد) برای محافظت از وضعیت خود استفاده میکرد.
Android 17 بهروزرسانی قابلتوجهی برای این مؤلفه ارائه میکند: پیادهسازی بدون قفل بهنام DeliQueue.
این پست توضیح میدهد که قفلها چگونه بر عملکرد میانای کاربر تأثیر میگذارند، چگونه این مشکلات را با Perfetto تجزیهوتحلیل کنید، و الگوریتمها و بهینهسازیهای خاصی که برای بهبود رشته اصلی Android استفاده میشوند چیست.
مشکل: رقابت قفل و وارونگی اولویت
MessageQueue قدیمی بهعنوان صف اولویتدار عمل میکرد که با یک قفل محافظت میشد. اگر رشته پسزمینه پیامی را پست کند درحالیکه رشته اصلی درحال انجام تعمیرات صف است، رشته پسزمینه رشته اصلی را مسدود میکند.
وقتی دو یا چند رشته برای استفاده انحصاری از یک قفل باهم رقابت میکنند، به آن رقابت قفل میگویند. این رقابت میتواند باعث وارونگی اولویت شود که به پرش میانای کاربر و سایر مشکلات عملکردی منجر میشود.
وارونگی اولویت زمانی رخ میدهد که رشتهای با اولویت بالا (مانند رشته میانای کاربر) مجبور شود منتظر رشتهای با اولویت پایین بماند. این توالی را درنظر بگیرید:
- رشته پسزمینه با اولویت پایین قفل
MessageQueueرا بهدست میآورد تا نتیجه کاری را که انجام داده است پست کند. - رشتهای با اولویت متوسط قابلاجرا میشود و زمانبند هسته زمان واحد پردازش مرکزی را به آن اختصاص میدهد و رشته با اولویت پایین را پیشدستی میکند.
- رشته میانای کاربر با اولویت بالا تکلیف فعلی خود را بهپایان میرساند و تلاش میکند از صف بخواند، اما مسدود میشود زیرا رشته با اولویت پایین قفل را نگه داشته است.
رشته با اولویت پایین رشته میانای کاربر را مسدود میکند و کار با اولویت متوسط آن را بیشتر بهتأخیر میاندازد.

تحلیل کردن رقابت با Perfetto
میتوانید این مشکلات را بااستفاده از Perfetto تشخیص دهید. در ردیابی استاندارد، رشتهای که در قفل مانیتور مسدود شده است وارد حالت خواب میشود و Perfetto برشی را نشان میدهد که مالک قفل را مشخص میکند.
وقتی دادههای ردیابی را پُرسمان میکنید، بهدنبال برشهایی با نام «monitor contention with …» (نظارت بر رقابت با …) بگردید که بهدنبال آن نام رشتهای که مالک قفل است و سایت کدی که قفل از آن بهدست آمده است میآید.
مطالعه موردی: پرش راهانداز
برای توضیح بیشتر، بیایید ردیابیای را تحلیل کنیم که در آن کاربر هنگام پیمایش به صفحه اصلی در تلفن Pixel بلافاصله پساز گرفتن عکس در برنامه دوربین، با لرزش مواجه شده است. در زیر، نماگرفتی از Perfetto را میبینیم که رویدادهای منتهی به فریم ازدسترفته را نشان میدهد:

- نشانه: رشته اصلی «راهانداز» مهلت قاب خود را ازدست داد. این ریسه بهمدت ۱۸ میلیثانیه مسدود شده است که از مهلت ۱۶ میلیثانیهای لازم برای پرداز ۶۰ هرتز فراتر رفته است.
- تشخیص: Perfetto نشان داد که رشته اصلی در قفل
MessageQueueمسدود شده است. رشته «BackgroundExecutor» مالک قفل بود. - علت ریشهای: BackgroundExecutor در Process.THREAD_PRIORITY_BACKGROUND (اولویت بسیار پایین) اجرا میشود. این برنامه کاری غیرفوری (بررسی حدود استفاده از برنامه) انجام داده است. همزمان، رشتههای با اولویت متوسط از زمان واحد پردازش مرکزی برای پردازش دادههای دوربین استفاده میکردند. زمانبند سیستمعامل رشته BackgroundExecutor را برای اجرای رشتههای دوربین پیشدستی کرد.
این توالی باعث شد رشته میانای کاربر «راهانداز» (اولویت بالا) بهطور غیرمستقیم توسط رشته عامل دوربین (اولویت متوسط) مسدود شود، که مانع از آزاد شدن قفل توسط رشته پسزمینه «راهانداز» (اولویت پایین) میشد.
پرسوجو کردن ردیابیها با PerfettoSQL
میتوانید از PerfettoSQL برای دادههای ردیابی پُرسمان برای الگوهای خاص استفاده کنید. این ویژگی زمانی مفید است که بانک بزرگی از ردگیریها از دستگاههای کاربر یا آزمایشها دارید و بهدنبال ردگیریهای خاصی هستید که مشکلی را نشان میدهند.
برای مثال، این پُرسمان MessageQueue رقابت همزمان با فریمهای حذفشده (پرش) را پیدا میکند:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
در این مثال پیچیدهتر، دادههای ردیابی را که در چندین جدول گسترده شدهاند، به هم بپیوندید تا رقابت MessageQueue را درطول راهاندازی برنامه شناسایی کنید:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
میتوانید از مدل زبانی بزرگ دلخواهتان برای نوشتن پُرسمانهای PerfettoSQL برای پیدا کردن الگوهای دیگر استفاده کنید.
ما در Google از BigTrace برای اجرای پُرسمانهای PerfettoSQL در میلیونها ردگیری استفاده میکنیم. با انجام این کار، تأیید کردیم که آنچه بهطور غیررسمی دیدیم درواقع یک مشکل سیستمی بود. دادهها نشان داد که رقابت قفل MessageQueue بر کاربران در سراسر بومسازگان تأثیر میگذارد و نیاز به تغییر معماری اساسی را اثبات میکند.
راهحل: همروندی بدون قفل
ما مشکل رقابت MessageQueue را با پیادهسازی ساختار داده بدون قفل، بااستفاده از عملیات حافظه اتمی بهجای قفلهای انحصاری برای همگامسازی دسترسی به حالت مشترک، برطرف کردیم. ساختار داده یا الگوریتم زمانی بدون قفل است که حداقل یک رشته بتواند همیشه بدون توجه به رفتار زمانبندی رشتههای دیگر پیشرفت کند. دستیابی به این ویژگی معمولاً دشوار است و معمولاً برای اکثر کدها ارزش دنبال کردن ندارد.
The atomic primitives
نرمافزار بدون قفل اغلب به دستورات اتمی «خواندن-اصلاح-نوشتن» که سختافزار ارائه میدهد متکی است.
در نسلهای قدیمیتر پردازندههای ARM64، اتمیکها از حلقه «بارگیری-پیوند/ذخیره-شرطی» (LL/SC) استفاده میکردند. واحد پردازش مرکزی مقداری را بار میکند و نشانی را علامتگذاری میکند. اگر رشته دیگری در آن نشانی بنویسد، ذخیره ناموفق میشود و حلقه دوباره امتحان میکند. چون رشتهها میتوانند بدون منتظر ماندن برای رشتهای دیگر به تلاش ادامه دهند و موفق شوند، این عملیات بدون قفل است.
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retrمعماریهای جدیدتر ARM (ARMv8.1) از افزونههای سیستم بزرگ (LSE) پشتیبانی میکنند که شامل دستورالعملهایی بهصورت «مقایسه و تعویض» (CAS) یا «بارگیری و افزودن» (در زیر نشان داده شده است) میشود. در Android 17، پشتیبانی از کامپایلر «زمان اجرای Android» (ART) را اضافه کردیم تا زمان پشتیبانی از LSE را شناسایی کند و دستورالعملهای بهینهشده را صادر کند:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
در محکهای ما، کد با رقابت بالا که از CAS استفاده میکند، حدود ۳ برابر سریعتر از نوع LL/SC است.
زبان برنامهنویسی Java ازطریق java.util.concurrent.atomic که به این دستورالعملها و دستورالعملهای تخصصی دیگر CPU متکی است، انواع دادههای اتمی را ارائه میدهد.
ساختار داده: DeliQueue
برای برداشتن رقابت قفل از MessageQueue، مهندسان ما ساختار داده جدیدی بهنام DeliQueue طراحی کردند. DeliQueue درج Message را از پردازش Message جدا میکند:
- فهرست
Messages(پشته Treiber): پشتهای بدون قفل. هر رشتهای میتواندMessagesجدید را بدون رقابت به اینجا ارسال کند. - صف اولویت (Min-heap): تودهای از
Messagesبرای رسیدگی، که منحصراً متعلق به رشته Looper است (بنابراین برای دسترسی به آن نیازی به همگامسازی یا قفل نیست).
Enqueue: pushing to a Treiber stack
فهرست Messages در پشته Treiber [۱] نگهداری میشود، پشتهای بدون قفل که از حلقه CAS برای بهروزرسانی اشارهگر سر استفاده میکند.
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
کد منبع براساس Java Concurrency in Practice [2]، دردسترس بهصورت آنلاین و منتشرشده در دامنه عمومی
هر تولیدکنندهای میتواند در هر زمانی Message جدیدی را به پشته اضافه کند. این کار مثل گرفتن بلیت در پیشخوان اغذیهفروشی است - شماره شما براساس زمان حضور شما تعیین میشود، اما ترتیبی که غذایتان را دریافت میکنید لزوماً نباید با آن مطابقت داشته باشد. چون پشته پیوندی است، هر Message یک زیرپشته است - میتوانید با ردیابی سر و تکرار رو به جلو ببینید صف Message در هر نقطهای از زمان چگونه بوده است - هیچ Message جدیدی را که در بالا قرار داده شده باشد نخواهید دید، حتی اگر درطول پیمایش شما اضافه شده باشند.
Dequeue: bulk transfer to a min-heap
برای پیدا کردن Message بعدی برای رسیدگی، Looper Messageهای جدید را از پشته Treiber با پیمایش پشته از بالا و تکرار تا زمانی که آخرین Message را که قبلاً پردازش کرده است پیدا کند، پردازش میکند. وقتی Looper پشته را بهسمت پایین طی میکند، Messageها را در پشته کمینه مرتبشده براساس مهلت درج میکند. ازآنجاییکه Looper بهطور انحصاری مالک پشته است، Messageها را بدون قفل یا اتمیک سفارش میدهد و پردازش میکند.
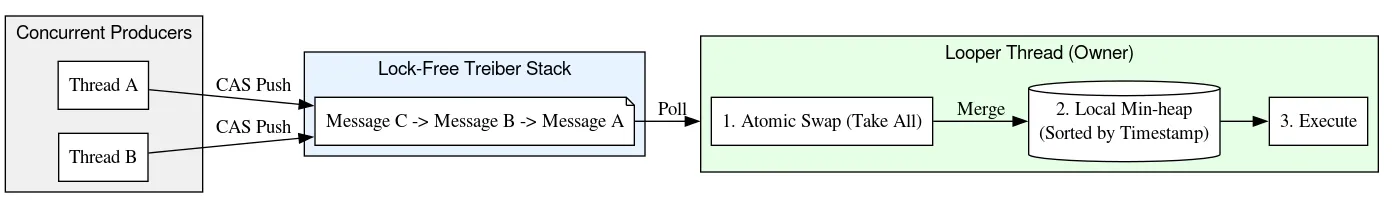
در پایین رفتن از پشته، Looper همچنین پیوندهایی از Messageهای پشتهشده به پیشینیان خود ایجاد میکند، بنابراین یک فهرست با پیوند دوگانه تشکیل میدهد. ایجاد فهرست پیوندی ایمن است زیرا پیوندهایی که به پایین پشته اشاره میکنند ازطریق الگوریتم پشته Treiber با CAS اضافه میشوند و پیوندهای بالای پشته فقط توسط رشته Looper خوانده و اصلاح میشوند. سپس از این پیوندهای برگشتی برای برداشتن Messageها از نقاط دلخواه در پشته در زمان O(1) استفاده میشود.
این طراحی درج O(1) را برای تولیدکنندگان (رشتههایی که کار را به صف ارسال میکنند) و پردازش مستهلکشده O(log N) را برای مصرفکننده (Looper) فراهم میکند.
استفاده از min-heap برای مرتب کردن Messages همچنین یک نقص اساسی در MessageQueue قدیمی را برطرف میکند، که در آن Messages در یک فهرست تکپیوندی (ریشه در بالا) نگهداری میشدند. در پیادهسازی قدیمی، برداشتن از سر O(1) بود، اما درج بدترین حالت O(N) را داشت – مقیاسبندی ضعیف برای صفهای بیشازحد بارگذاریشده! برعکس، درج و حذف از پشته کمینه بهصورت لگاریتمی مقیاسبندی میشود که عملکرد متوسط رقابتی ارائه میدهد اما واقعاً در تأخیرهای دنباله برتری دارد.
قدیمی (قفلشده) MessageQueue | DeliQueue | |
| درج کردن | O(N) | O(1) برای رشته تماس O(logN) برای رشته |
| برداشتن از سر | O(۱) | O(logN) |
در پیادهسازی صف قدیمی، تولیدکنندگان و مصرفکننده از یک قفل برای هماهنگ کردن دسترسی انحصاری به فهرست تکپیوندی زیرین استفاده میکردند. در DeliQueue، پشته Treiber دسترسی همزمان را مدیریت میکند و مصرفکننده واحد صف کار خود را مرتب میکند.
برداشتن: سازگاری ازطریق سنگ قبر
DeliQueue یک ساختار داده ترکیبی است که یک پشته Treiber بدون قفل را با یک min-heap تکرشتهای ترکیب میکند. همگام نگه داشتن این دو ساختار بدون قفل سراسری چالش منحصربهفردی را ایجاد میکند: ممکن است پیامی بهصورت فیزیکی در پشته وجود داشته باشد اما بهصورت منطقی از صف برداشته شده باشد.
برای حل این مشکل، DeliQueue از تکنیکی به نام «سنگ قبر» استفاده میکند. هر Message موقعیت خود را در پشته ازطریق اشارهگرهای عقب و جلو، شاخص خود در آرایه توده، و یک پرچم بولی که نشان میدهد آیا برداشته شده است یا نه، ردیابی میکند. وقتی Message آماده اجرا باشد، رشته Looper پرچم برداشتهشده آن را CAS میکند، سپس آن را از پشته و توده برمیدارد.
وقتی رشته دیگری نیاز به برداشتن Message دارد، آن را فوراً از ساختار داده استخراج نمیکند. درعوض، مراحل زیر را انجام میدهد:
- برداشتن منطقی: رشته از CAS برای تنظیم اتمی پرچم برداشتن
Messageاز نادرست به درست استفاده میکند.Messageدر ساختار داده بهعنوان مدرکی برای برداشتن معلق آن باقی میماند، که به آن «سنگ قبر» میگویند. وقتیMessageبرای برداشتن پرچمگذاری میشود، DeliQueue هر زمان که آن را پیدا کند، طوری با آن رفتار میکند که گویی دیگر در صف وجود ندارد. - پاکسازی معوق: برداشتن واقعی از ساختار داده برعهده رشته
Looperاست و به بعد موکول میشود. رشته حذفکننده بهجای اصلاح پشته یا پشته حافظه،Messageرا به پشته فهرست آزاد بدون قفل دیگری اضافه میکند. - برداشتن ساختاری: فقط
Looperمیتواند با توده تعامل داشته باشد یا عناصر را از پشته بردارد. وقتی بیدار میشود، فهرست آزاد را پاک میکند وMessageهای موجود در آن را پردازش میکند. سپس پیوند هرMessageاز پشته قطع میشود و از توده برداشته میشود.
این رویکرد باعث میشود که همه مدیریت پشته تکرشتهای باقی بماند. این کار تعداد عملیات همزمان و موانع حافظه موردنیاز را بهحداقل میرساند و مسیر بحرانی را سریعتر و سادهتر میکند.
Traversal: benign Java memory model data races
اکثر میاناهای برنامهسازی کاربردی همزمان، مانند Future در کتابخانه استاندارد جاوا، یا Job و Deferred Kotlin، شامل مکانیزمی برای لغو کار قبلاز تکمیل آن هستند. نمونهای از یکی از این کلاسها با واحدی از کار اساسی مطابقت ۱:۱ دارد و فراخوانی cancel در یک شیء، عملیات خاص مرتبط با آنها را لغو میکند.
دستگاههای Android امروزی دارای پردازنده مرکزی چندهستهای و زبالهروبی نسلی همزمان هستند. اما وقتی Android برای اولینبار توسعه یافت، اختصاص دادن یک شیء برای هر واحد کار بسیار پرهزینه بود. درنتیجه، Handler در Android از لغو کردن ازطریق چندین اضافهبار removeMessages پشتیبانی میکند - بهجای برداشتن یک Message خاص، همه Messageهایی را که با معیارهای مشخصشده مطابقت دارند برمیدارد. در عمل، این کار مستلزم تکرار کردن همه Messageهای درجشده قبلاز فراخوانی removeMessages و برداشتن موارد منطبق است.
هنگام تکرار رو به جلو، یک رشته فقط به یک عملیات اتمی مرتبشده نیاز دارد تا سر فعلی پشته را بخواند. پساز آن، از خواندن فیلد معمولی برای پیدا کردن Message بعدی استفاده میشود. اگر رشته Looper فیلدهای next را هنگام برداشتن Messages اصلاح کند، نوشتن Looper و خواندن رشته دیگر همگامسازی نمیشوند - این یک رقابت داده است. معمولاً رقابت دادهها اشکال جدیای است که میتواند مشکلات بزرگی در برنامهتان ایجاد کند - نشت، حلقههای بینهایت، ازکارافتادن، توقف، و غیره. بااینحال، تحت شرایط محدود خاصی، رقابت دادهها میتواند در «مدل حافظه Java» بیخطر باشد. فرض کنید با پشتهای از این موارد شروع میکنیم:

ما یک خواندن اتمی از سر انجام میدهیم و A را میبینیم. اشارهگر بعدی A به B اشاره میکند. همزمان با پردازش B، لوپر ممکن است B و C را با بهروزرسانی A برای اشاره به C و سپس D حذف کند.
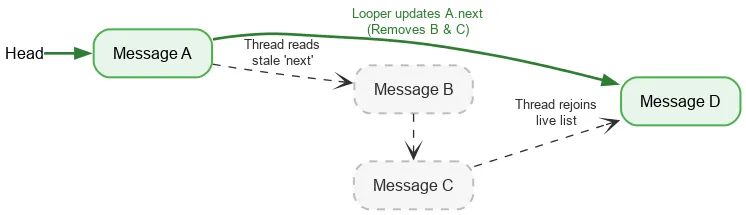
Even though B and C are logically removed, B retains its next pointer to C, and C to D. رشته خواندن به پیمایش در گرههای حذفشده جداشده ادامه میدهد و درنهایت در D دوباره به پشته فعال میپیوندد.
با طراحی DeliQueue برای مدیریت رقابت بین پیمایش و حذف، امکان تکرار ایمن و بدون قفل را فراهم میکنیم.
Quitting: Native refcount
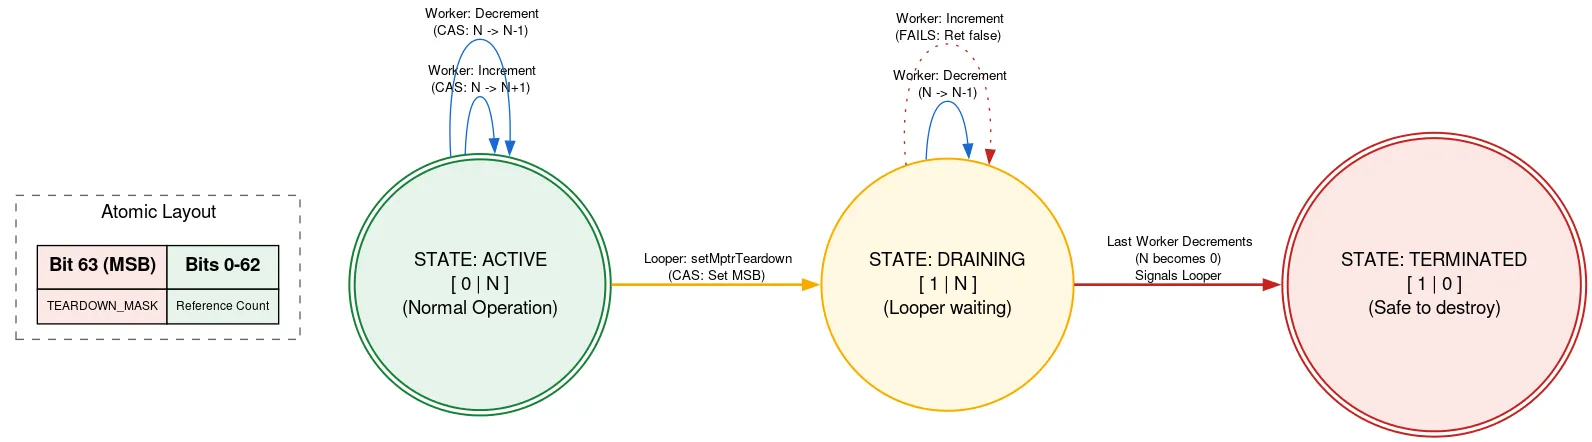
Looper توسط یک تخصیص بومی پشتیبانی میشود که باید پساز خروج Looper بهصورت دستی آزاد شود. اگر رشته دیگری درحال افزودن Message باشد درحالیکه Looper درحال خروج است، میتواند از تخصیص بومی پساز آزاد شدن استفاده کند که این نقض ایمنی حافظه است. ما بااستفاده از شمارش ارجاع برچسبگذاریشده از این امر جلوگیری میکنیم، که در آن از یک بیت اتمی برای نشان دادن اینکه آیا Looper درحال خروج است یا نه استفاده میشود.
قبلاز استفاده از تخصیص بومی، رشته refcount atomic را میخواند. اگر بیت خروج تنظیم شده باشد، برمیگرداند که Looper درحال خروج است و نباید از تخصیص بومی استفاده شود. اگر نه، CAS را امتحان میکند تا تعداد رشتههای فعال را بااستفاده از تخصیص بومی افزایش دهد. پساز انجام کارهای لازم، شمارش را کاهش میدهد. اگر بیت خروج پساز افزایش اما قبلاز کاهش تنظیم شده باشد و شمارش اکنون صفر باشد، رشته Looper را بیدار میکند.
وقتی رشته Looper آماده خروج است، از CAS برای تنظیم بیت خروج در اتمی استفاده میکند. اگر refcount صفر باشد، میتواند به آزادسازی تخصیص بومی خود ادامه دهد. درغیراینصورت، خودش را پارک میکند، با این آگاهی که وقتی آخرین کاربر تخصیص بومی refcount را کاهش دهد، بیدار خواهد شد. این رویکرد به این معنی است که رشته Looper منتظر پیشرفت رشتههای دیگر میماند، اما فقط زمانی که درحال خروج است. این اتفاق فقط یکبار میافتد و به عملکرد حساس نیست، و کد دیگر را برای استفاده از تخصیص بومی کاملاً بدون قفل نگه میدارد.
ترفندها و پیچیدگیهای بسیار دیگری در پیادهسازی وجود دارد. با مرور کد منبع میتوانید درباره DeliQueue بیشتر بدانید.
بهینهسازی: برنامهنویسی بدون انشعاب
درطول توسعه و آزمایش DeliQueue، تیم محکهای زیادی را اجرا کرد و کد جدید را بهدقت نمایهسازی کرد. یکی از مشکلات شناساییشده بااستفاده از ابزار simpleperf، پاکسازی خط لوله ناشی از کد مقایسهگر Message بود.
یک مقایسهکننده استاندارد از پرشهای شرطی استفاده میکند، با شرط تصمیمگیری درباره اینکه کدام Message ابتدا در زیر ساده شده است:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
این کد به پرشهای شرطی (دستورالعملهای b.le و cbnz) کامپایل میشود. وقتی CPU با یک شاخه شرطی مواجه میشود، نمیتواند بداند که آیا شاخه گرفته شده است یا نه تا زمانی که شرط محاسبه شود، بنابراین نمیداند کدام دستورالعمل را باید در مرحله بعد بخواند و باید بااستفاده از تکنیکی به نام پیشبینی شاخه حدس بزند. در موردی مانند جستجوی دودویی، جهت شاخه در هر مرحله بهطور غیرقابلپیشبینی متفاوت خواهد بود، بنابراین احتمالاً نیمی از پیشبینیها اشتباه خواهد بود. پیشبینی انشعاب اغلب در الگوریتمهای جستجو و مرتبسازی (مانند الگوریتمی که در پشته کمینه استفاده میشود) بیتأثیر است، زیرا هزینه حدس اشتباه بیشتر از بهبود حاصل از حدس درست است. وقتی پیشبینیکننده انشعاب اشتباه حدس میزند، باید کاری را که پساز فرض مقدار پیشبینیشده انجام داده است دور بیندازد و دوباره از مسیری که واقعاً طی شده است شروع کند - به این کار پاکسازی خط لوله میگویند.
برای پیدا کردن این مشکل، محکهایمان را بااستفاده از شمارنده عملکرد branch-misses نمایهسازی کردیم که ردیابیهای پشته را در جایی که پیشبینیکننده شاخه اشتباه حدس میزند ثبت میکند. سپس نتایج را با Google pprof تجسم کردیم، همانطور که در زیر نشان داده شده است:

بهیاد داشته باشید که کد اصلی MessageQueue از فهرست پیوندی تکی برای صف مرتبشده استفاده میکرد. درج کردن، فهرست را بهترتیب مرتبشده بهعنوان جستجوی خطی پیمایش میکند، در اولین عنصری که از نقطه درج گذشته است متوقف میشود، و Message جدید را قبلاز آن پیوند میدهد. برای برداشتن از سر، کافی است پیوند سر را قطع کنید. درحالیکه DeliQueue از min-heap استفاده میکند، که در آن جهشها نیاز به مرتبسازی مجدد برخی عناصر (غربال کردن به بالا یا پایین) با پیچیدگی لگاریتمی در یک ساختار داده متعادل دارند، جایی که هر مقایسه شانس یکسانی برای هدایت پیمایش به فرزند چپ یا فرزند راست دارد. الگوریتم جدید بهطور مجانبی سریعتر است، اما گلوگاه جدیدی را نشان میدهد زیرا کد جستجو نیمی از مواقع بهدلیل عدم تطابق شاخه متوقف میشود.
با درک اینکه خطاهای انشعاب باعث کند شدن کد پشته ما میشد، کد را بااستفاده از برنامهنویسی بدون انشعاب بهینهسازی کردیم:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
برای درک بهینهسازی، دو مثال را در Compiler Explorer ازهم باز کنید و از LLVM-MCA استفاده کنید، شبیهساز واحد پردازش مرکزی که میتواند خط زمان تخمینی چرخههای واحد پردازش مرکزی را تولید کند.
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
به یک شاخه شرطی، b.le، توجه کنید که اگر نتیجه از قبل از مقایسه فیلدهای when مشخص باشد، از مقایسه فیلدهای insertSeq اجتناب میکند.
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
در اینجا، پیادهسازی بدون انشعاب چرخهها و دستورالعملهای کمتری نسبت به کوتاهترین مسیر ازطریق کد انشعابی دارد - در همه موارد بهتر است. پیادهسازی سریعتر بهعلاوه حذف شاخههای پیشبینینشده منجر به بهبود ۵ برابری در برخیاز محکهای ما شد!
بااینحال، این تکنیک همیشه قابلاجرا نیست. رویکردهای بدون انشعاب معمولاً نیاز به انجام کاری دارند که دور انداخته میشود، و اگر انشعاب در بیشتر مواقع قابلپیشبینی باشد، این کار هدررفته میتواند سرعت کد شما را کاهش دهد. علاوهبراین، برداشتن شاخه اغلب باعث ایجاد وابستگی داده میشود. واحدهای پردازش مرکزی مدرن چندین عملیات را در هر چرخه اجرا میکنند، اما نمیتوانند دستورالعملی را اجرا کنند تا زمانی که ورودیهای آن از دستورالعمل قبلی آماده شود. درمقابل، CPU میتواند درباره دادهها در شاخهها گمانهزنی کند و اگر شاخهای بهدرستی پیشبینی شود، کار را جلو ببرد.
آزمایش و اعتبارسنجی
اعتبارسنجی درستی الگوریتمهای بدون قفل بسیار دشوار است!
علاوهبر آزمونهای واحد استاندارد برای اعتبارسنجی مداوم درطول توسعه، آزمونهای فشار دقیقی نیز نوشتیم تا ثابتهای صف را تأیید کنیم و درصورت وجود رقابت دادهها، آنها را القا کنیم. در آزمایشگاههای آزمایشیمان میتوانیم میلیونها نمونه آزمایشی را در دستگاههای شبیهسازیشده و سختافزار واقعی اجرا کنیم.
با ابزار دقیق Java ThreadSanitizer (JTSan)، میتوانیم از همان آزمایشها برای شناسایی برخیاز رقابتهای داده در کد خود نیز استفاده کنیم. JTSan هیچ رقابت دادهای مشکلسازی در DeliQueue پیدا نکرد، اما - درکمال تعجب - دو اشکال همزمانی در چارچوب Robolectric شناسایی کرد که فوراً آنها را برطرف کردیم.
برای بهبود قابلیتهای اشکالزدایی، ابزارهای تجزیهوتحلیل جدیدی ساختیم. در زیر مثالی نشان داده شده است که مشکلی را در کد پلاتفرم Android نشان میدهد که در آن یک رشته با Message، رشته دیگری را بیشازحد بارگذاری میکند و باعث ایجاد یک عقبماندگی بزرگ میشود که بهلطف ویژگی ابزار دقیق MessageQueue که اضافه کردیم، در Perfetto قابلمشاهده است.

برای فعال کردن ردیابی MessageQueue در فرایند system_server ، موارد زیر را در پیکربندی Perfetto خود اضافه کنید:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
تأثیر
DeliQueue با حذف قفلها از MessageQueue، عملکرد سیستم و برنامه را بهبود میبخشد.
- معیارهای مصنوعی: درجهای چندرشتهای در صفهای شلوغ تا ۵٬۰۰۰ برابر سریعتر از
MessageQueueقدیمی است، که این امر بهدلیل همزمانی بهبودیافته (پشته Treiber) و درجهای سریعتر (min-heap) است. - در ردیابیهای Perfetto که از آزمایشکنندگان بتای داخلی بهدست آمده است، شاهد کاهش ۱۵ درصدی در زمان صرفشده در رشته اصلی برنامه در رقابت قفل هستیم.
- در همان دستگاههای آزمایشی، کاهش رقابت قفل منجر به بهبود قابلتوجهی در تجربه کاربری میشود، مانند:
- -۴٪ قاب ازدسترفته در برنامهها.
- -۷٫۷٪ فریم ازدسترفته در تعاملات «راهانداز» و «میانای کاربر سیستم».
- -۹٫۱٪ در زمان راهاندازی برنامه تا ترسیم اولین قاب، در صدک ۹۵.
مراحل بعدی
DeliQueue درحال عرضه شدن برای برنامهها در Android 17 است. توسعهدهندگان برنامه باید برای آشنایی با نحوه آزمایش برنامههایشان، آمادهسازی برنامه برای MessageQueue جدید بدون قفل را در وبلاگ «توسعهدهندگان Android» مرور کنند.
مرجعها
[۱] Treiber, R.K., ۱۹۸۶. برنامهنویسی سیستمها: مقابله با موازیسازی. International Business Machines Incorporated, Thomas J. مرکز تحقیقات واتسون.
[۲] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., & Lea, D. (2006). Java Concurrency in Practice. Addison-Wesley Professional.
-


 اخبار محصول
ببینید ابزارهای گسترش کانال Google Play در «کنسول Play» چگونه دسترسی خریدار را در سراسر فروشگاه، وب، و سطوح خارجی گسترش میدهند و درعینحال از حاشیه سود محافظت میکنند.
Phalene Gowling, Rejane França • زمان خواندن: ۴ دقیقه -

 اخبار محصول
با Unity که بیشاز نیمی از همه عناوین تلفن همراه در سراسر جهان را پشتیبانی میکند، برداشت اولیه اهمیت دارد. برای توسعهدهندگان بازی، تجربه آمادهسازی روان و قابلاعتماد بازیکن برای حفظ بازیکن در روز اول و تعامل بلندمدت ضروری است.
Michelle Martin • زمان خواندن: ۱ دقیقه -


 اخبار محصول
از غوطهوری کامل در خانه تا تجربههای اجمالی درحال حرکت، ساختن روی Android XR به شما امکان میدهد در هر لحظه در سراسر طیف برنامههای فضایی با کاربران ملاقات کنید. در «نشست توسعهدهندگان Android»، با راهاندازی XREAL AURA به نقطه عطف هیجانانگیزی رسیدیم.
Amy Zeppenfeld, Vinny DaSilva • مدتزمان مطالعه: ۳ دقیقه
جدیدترین اطلاعات آماری توسعه Android را بهصورت هفتگی در صندوق ورودیتان دریافت کنید.
