

GPU 렌더링 프로파일링 도구는 렌더링 파이프라인의 각 단계에서 이전 프레임을 렌더링하는 데 걸리는 상대적인 시간을 나타냅니다. 이 정보는 파이프라인의 병목 현상을 식별하는 데 도움이 되므로 앱의 렌더링 성능을 향상하기 위해 최적화해야 하는 항목을 파악할 수 있습니다.
이 페이지에서는 각 파이프라인 단계에서 발생하는 상황을 간략하게 설명하고 병목 현상을 일으킬 수 있는 문제에 관해 논의합니다. 이 페이지를 읽기 전에 GPU 렌더링 속도 프로파일링에 있는 정보를 숙지해야 합니다. 또한 모든 단계가 유기적으로 잘 작동하는 방식을 이해하려면 렌더링 파이프라인의 작동 방식을 검토하는 것이 좋습니다.
시각적 표현
GPU 렌더링 프로파일링 도구는 단계와 각 단계의 상대적인 시간을 그래프(색상으로 구분된 히스토그램) 형태로 표시합니다. 그림 1은 이러한 표시의 예를 보여줍니다.
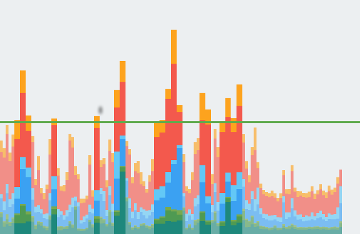
GPU 렌더링 프로파일링 그래프에 표시된 세로 막대의 각 세그먼트는 파이프라인의 단계를 나타내며 막대그래프에서 특정 색상을 사용하여 강조표시됩니다. 그림 2는 표시된 각 색상의 핵심 의미를 보여줍니다.

각 색상의 의미를 이해하고 나면 앱의 특정 측면을 타겟팅하여 렌더링 성능을 최적화하도록 시도할 수 있습니다.
단계와 단계별 의미
이 섹션에서는 각 단계에서 일어나는 일과 주의해야 하는 병목 현상의 원인에 관해 설명합니다.
입력 처리
파이프라인의 입력 처리 단계는 앱이 입력 이벤트를 처리하는 데 걸린 시간을 측정합니다. 이 측정항목은 앱이 입력 이벤트 콜백의 결과로 호출된 코드를 실행하는 데 걸린 시간을 나타냅니다.
이 세그먼트가 큰 경우
일반적으로 이 영역의 값이 큰 것은 입력-핸들러 이벤트 콜백 내에서 발생하는 작업이 너무 많거나 너무 복잡하기 때문입니다. 이러한 콜백은 항상 기본 스레드에서 발생하므로 이 문제를 해결하려면 작업을 직접 최적화하거나 다른 스레드로 작업을 오프로드하는 것에 초점을 두어야 합니다.
LazyColumn 또는 LazyRow을 스크롤하는 것도 이 단계에 표시될 수 있습니다. 사용자 터치가 스크롤로 간주되면 지연 목록은 터치 이벤트를 사용하여 항목을 동적으로 구성하고 배치합니다. 앱이 스크롤 위치에 응답하는 맞춤 작업을 실행하는 경우 프레임이 삭제되지 않도록 이 작업을 최대한 빠르게 실행하는 것이 중요합니다. Android 스튜디오의 CPU 프로파일러 또는 Perfetto와 같은 프로파일링 도구를 사용하면 더 자세히 조사할 수 있습니다. 자세한 내용은 시스템 추적 개요를 참고하세요.
애니메이션
애니메이션 단계는 해당 프레임에서 실행 중인 모든 애니메이션 상태를 평가하는 데 걸린 시간을 보여줍니다. Compose의 일반적인 애니메이션 API는 animate*AsState, Transition, Animatable입니다.
또한 이 단계에서 리컴포저가 실행되어 스냅샷 상태 변경사항을 처리하고 컴포지션을 업데이트합니다. 즉, 리컴포지션 오버헤드가 애니메이션 단계 내에 직접 표시되는 경우가 많습니다.
Jetpack Compose UI의 경우 Compose 런타임 추적 라이브러리를 포함하여 시스템 이벤트와 함께 자세한 컴포지션 추적을 확인하세요.
이 세그먼트가 큰 경우
일반적으로 이 영역의 값이 큰 것은 애니메이션으로 인해 상태가 변경되어 실행 중인 작업 때문입니다. 예를 들어 LazyColumn 또는 LazyRow를 스크롤하는 플링 애니메이션은 새 목록 항목의 빠른 구성, 측정, 할당을 야기합니다.
측정
화면에 컴포저블을 그리려면 Android는 UI 트리의 레이아웃 노드에 걸쳐 세 단계를 실행합니다.
먼저 시스템이 레이아웃 노드를 측정합니다. 모든 컴포저블에는 화면의 객체 크기 제한을 설명하는 특정 제약 조건과 수정자가 있습니다. 일부 컴포저블은 특정 고정 크기를 가질 수 있으며, 다른 컴포저블은 상위 요소 레이아웃 컨테이너에서 전달된 제약 조건에 맞게 조정된 크기를 갖습니다.
둘째, 시스템은 레이아웃 노드를 배치합니다. 측정 단계에서 Compose가 하위 노드의 크기를 계산하면 배치 단계로 진행할 수 있습니다. 이 단계에서는 화면에 레이아웃 노드의 크기를 지정하고 위치를 지정합니다.
시스템은 효율성을 위해 항상 이 단일 패스 레이아웃을 실행합니다. 컴포저블 레이아웃이 무효화되면 Compose는 해당 노드를 측정하고 하위 요소가 크기나 제약 조건을 변경하는 경우에만 레이아웃 업데이트를 상위 계층 구조로 전파합니다.
이 세그먼트가 큰 경우
이 영역의 세그먼트가 크면 앱이 레이아웃 단계에서 너무 많은 시간을 소비하고 있다는 의미입니다. 이 단계에서는 레이아웃 노드의 위치를 지정하고 크기를 결정합니다. 이러한 작업에는 컴포저블의 측정 및 배치 수정자 실행이 포함되며, 레이아웃 트리가 지나치게 복잡하면 프레임 준비가 지연될 수 있습니다. 이러한 경우 성능을 해결하려면 Compose 앱을 벤치마킹하고 성능 권장사항을 따라야 합니다.
Android 스튜디오의 CPU 프로파일러 또는 Perfetto를 사용하여 레이아웃 패스를 검사하고 병목 현상을 식별합니다. 자세한 내용은 시스템 추적 개요를 참고하세요.
그리기
그리기 단계는 백그라운드, 모양 또는 텍스트 그리기와 같은 렌더링 작업을 기본 그리기 명령어 시퀀스로 변환합니다. 시스템은 이러한 명령어를 GPU 실행을 위한 표시 목록에 캡처합니다.
그리기 막대는 이 프레임의 화면에서 업데이트해야 하는 모든 레이아웃 노드와 관련해 명령어를 표시 목록에 캡처하는 데 걸린 시간을 기록합니다. 측정된 시간은 draw 수정자 또는 Canvas 컴포저블 내에 있을 수 있는 맞춤 그리기 로직에도 적용됩니다.
이 세그먼트가 큰 경우
간단히 말해 이 측정항목은 무효화된 각 레이아웃 노드에서 모든 그리기 명령어를 실행하는 데 걸린 시간을 보여줍니다.
이 측정에는 이러한 명령어를 하위 노드와 벡터 드로어블에 디스패치하는 데 걸린 시간이 포함됩니다. 이런 이유로, 막대가 급증한 경우 갑자기 많은 컴포저블이 무효가 된 것이 원인일 수 있습니다. 무효화로 인해 그리기 명령어를 다시 실행하고 레이아웃 노드의 표시 목록을 다시 생성해야 합니다. 또는 DrawScope 구현에 매우 복잡한 로직이 있는 몇몇 맞춤 컴포저블이나 캔버스로 인해 시간이 길어질 수도 있습니다.
또한 Compose는 플랫폼에서 그리기 단계로 간주하는 단계 내에서 내부 측정 및 레이아웃 패스를 처리하는 경우가 많습니다. 따라서 그리기 명령어뿐만 아니라 비용이 많이 들거나 과도한 내부 측정/레이아웃 작업으로 인해 그리기 막대가 높아질 수 있습니다. 확실하지 않은 경우 Perfetto 트레이스를 캡처하여 오버헤드가 그리기 루틴에서 발생하는지 아니면 Compose 측정 및 레이아웃 패스에서 발생하는지 확인하세요.
업로드
업로드 측정항목은 현재 프레임에서 비트맵 객체를 CPU 메모리에서 GPU 메모리로 전송하는 데 걸리는 시간을 나타냅니다.
CPU와 GPU는 서로 다른 프로세서로 처리 전용 RAM 영역이 다릅니다. Android에서 비트맵을 그릴 때 시스템은 GPU가 화면에 렌더링하기 전에 GPU 메모리로 비트맵을 전송합니다. 그런 다음, 텍스처가 GPU 텍스처 캐시에서 제거되지 않는 한 시스템이 데이터를 다시 전송할 필요가 없도록 GPU는 비트맵을 캐시합니다.
참고: Lollipop 기기에서 이 단계는 보라색입니다.
이 세그먼트가 큰 경우
프레임의 모든 리소스는 프레임을 그리는 데 사용되기 전에 GPU 메모리에 있어야 합니다. 즉, 이 측정항목의 값이 크면 작은 리소스 로드가 많이 있거나 적지만 매우 큰 리소스가 있다는 의미입니다. 일반적으로 앱이 화면 크기에 가까운 단일 비트맵을 표시하는 경우입니다. 또 다른 경우로 앱이 다수의 썸네일을 표시하는 것을 들 수 있습니다.
이 막대를 축소하려면 다음과 같은 기법을 사용하면 됩니다.
- 비트맵 해상도가 표시되는 크기보다 많이 큰 것은 아닌지 확인합니다. 예를 들어 1024x1024 이미지를 48x48 이미지로 표시하는 것을 피해야 합니다.
- Coil과 같은 최신 라이브러리를 활용하여 다음 동기화 단계 전에 비트맵을 비동기로 미리 업로드합니다.
명령어 실행
명령어 실행 세그먼트는 표시 목록을 화면에 그리기 위해 필요한 모든 명령어를 실행하는 데 걸리는 시간을 나타냅니다.
시스템이 화면에 표시 목록을 그리기 위해 GPU에 필요한 명령어를 보냅니다. 일반적으로 OpenGL ES API를 사용하여 이 작업을 실행합니다.
이 절차는 시스템이 GPU로 명령어를 보내기 전에 각 명령어에 최종 변환 및 클리핑을 실행하기 때문에 어느 정도 시간이 걸립니다. 그런 다음에는 최종 명령어를 계산하는 GPU 측에서 추가 오버헤드가 발생합니다. 이러한 명령어는 최종 변환 및 추가 클리핑을 포함합니다.
이 세그먼트가 큰 경우
이 단계에서 소요되는 시간은 시스템이 특정 프레임에서 렌더링하는 디스플레이 목록의 복잡성과 수량을 직접 측정한 것입니다. 예를 들어 그리기 작업이 많을 경우, 특히 각 그리기 프리미티브에 적지만 내재된 비용이 있는 경우에는 이 시간이 증가할 수 있습니다. 예를 들면 다음과 같습니다.
for (i in 0 until 1000) {
    canvas.drawPoint()
}
위의 예는 아래 코드보다 실행하는 데 훨씬 큰 비용이 발생합니다.
canvas.drawPoints(thousandPointArray)
명령어를 실행하는 것과 실제로 표시 목록을 그리는 것 사이에 항상 1:1의 상관관계가 있는 것은 아닙니다. GPU에 그리기 명령어를 보내는 데 걸리는 시간을 캡처하는 명령어 실행 막대와 달리 그리기 측정항목은 표시 목록에 실행된 명령어를 캡처하는 데 걸린 시간을 나타냅니다.
디스플레이 목록은 가능한 한 시스템에서 캐시하므로 이러한 차이가 발생합니다. 결과적으로 스크롤, 변환 또는 애니메이션을 위해 시스템이 표시 목록을 다시 보내야 하지만 실제로 처음부터 다시 빌드할 필요는 없는(즉, 그리기 명령어를 다시 캡처) 상황이 있습니다. 그 결과 높은 그리기 명령어 막대는 표시되지 않고 높은 명령어 실행 막대가 표시됩니다.
버퍼 전환
Android가 표시 목록을 GPU에 제출하면 시스템은 마지막 명령어를 실행하여 그래픽 드라이버에 현재 프레임이 완료되었음을 알립니다. 이 시점에서 드라이버는 최종적으로 업데이트된 이미지를 화면에 표시할 수 있습니다.
이 세그먼트가 큰 경우
GPU는 CPU와 병렬로 작업을 실행한다는 점을 알아야 합니다. Android 시스템은 GPU에 그리기 명령어를 실행한 후 다음 작업으로 넘어갑니다. GPU는 이러한 그리기 명령어를 큐에서 읽고 처리합니다.
CPU가 GPU에서 처리하는 것보다 빠르게 명령어를 실행하면 프로세서 간의 통신 큐가 가득 찰 수 있습니다. 이 경우 CPU는 작업을 중단하고 큐에 다음 명령어를 넣을 공간이 생길 때까지 대기합니다. 이렇게 큐가 가득 차는 상태는 버퍼 전환 단계에서 자주 발생하는데 그 이유는 이 단계에서 전체 프레임 분량의 명령어가 제출되었기 때문입니다.
이 문제를 해결하기 위한 핵심은 명령어 실행 단계에서 하는 것과 비슷한 방식으로 GPU에서 발생하는 작업의 복잡성을 줄이는 것입니다.
기타
렌더링 시스템이 작업을 실행하는 데 걸리는 시간 외에 기본 스레드에서 발생하며 렌더링과는 관계없는 일련의 추가 작업이 있습니다. 이 작업이 소비하는 시간은 기타 시간으로 보고됩니다. 기타 시간은 일반적으로 렌더링의 연속된 두 프레임 간의 UI 스레드에서 발생할 수 있는 작업을 나타냅니다.
이 세그먼트가 큰 경우
이 값이 높으면 앱에 다른 스레드에서 발생해야 하는 콜백, 인텐트 또는 기타 작업이 있을 수 있습니다. Android 스튜디오의 CPU 프로파일러 또는 Perfetto와 같은 도구를 사용하면 기본 스레드에서 실행 중인 작업을 확인할 수 있습니다. 이 정보는 타겟 성능을 향상하는 데 도움이 됩니다. 자세한 내용은 시스템 추적 개요를 참고하세요.