

使用 ProfilingManager 收集多个跟踪记录后,逐个探索这些跟踪记录以查找性能问题变得不切实际。通过批量跟踪分析,您可以同时查询跟踪记录数据集,以便:
- 识别常见的性能回归。
- 计算统计分布(例如 P50、P90、P99 延迟时间)。
- 在多个跟踪记录中查找模式。
- 查找离群跟踪记录,以了解和调试性能问题。
本部分演示了如何使用 Perfetto Python 批量跟踪记录处理器分析一组本地存储的跟踪记录中的启动指标,并找出离群跟踪记录以进行更深入的分析。
设计查询
执行批量分析的第一步是创建 PerfettoSQL 查询。
在本部分中,我们将提供一个用于衡量应用启动延迟时间的示例查询。
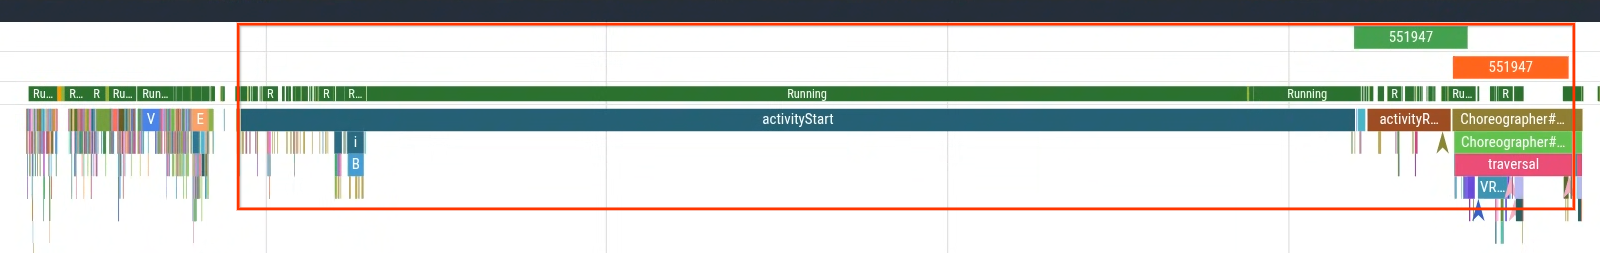
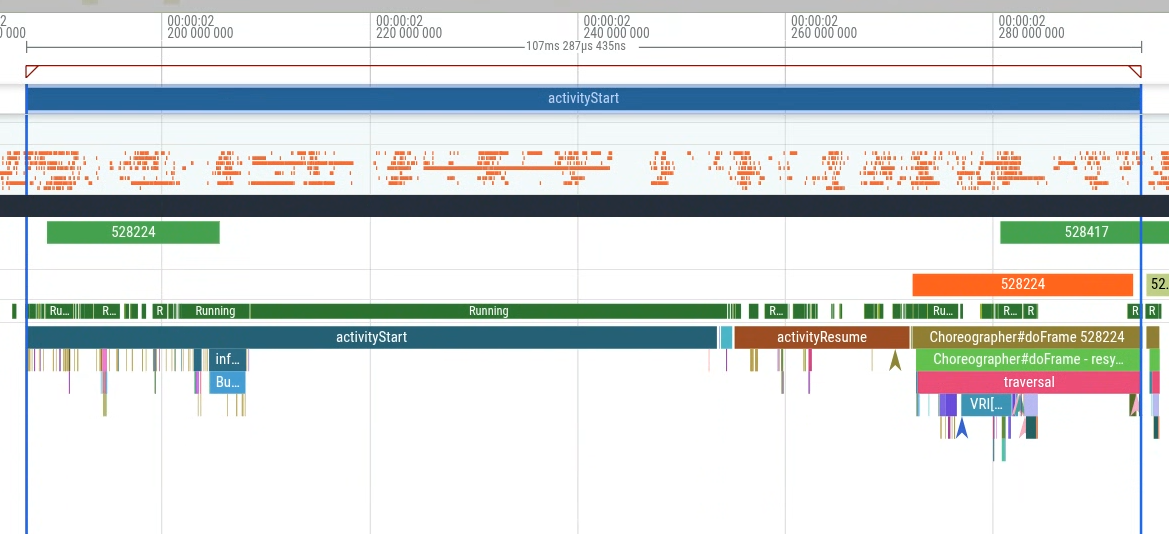
具体而言,您可以测量从 activityStart 到生成的第一个帧(Choreographer#doFrame 切片的首次出现)的时长,以测量应用控制范围内的应用启动延迟时间。图 1 显示了要查询的部分。
CREATE OR REPLACE PERFETTO FUNCTION find_slices(pattern STRING) RETURNS
TABLE (name STRING, ts LONG, dur LONG) AS
SELECT name,ts,dur FROM slice WHERE name GLOB $pattern;

CREATE OR REPLACE PERFETTO FUNCTION generate_start_to_end_slices(startSlicePattern STRING, endSlicePattern STRING, inclusive BOOL) RETURNS
TABLE(name STRING, ts LONG, dur LONG) AS
SELECT name, ts, MIN(startToEndDur) as dur
FROM
  (SELECT S.name as name, S.ts as ts, E.ts + IIF($inclusive, E.dur, 0) - S.ts as startToEndDur
  FROM find_slices($startSlicePattern) as S CROSS JOIN find_slices($endSlicePattern) as E
  WHERE startToEndDur > 0)
GROUP BY name, ts;

SELECT ts,name,dur from generate_start_to_end_slices('activityStart','*Choreographer#doFrame [0-9]*', true)
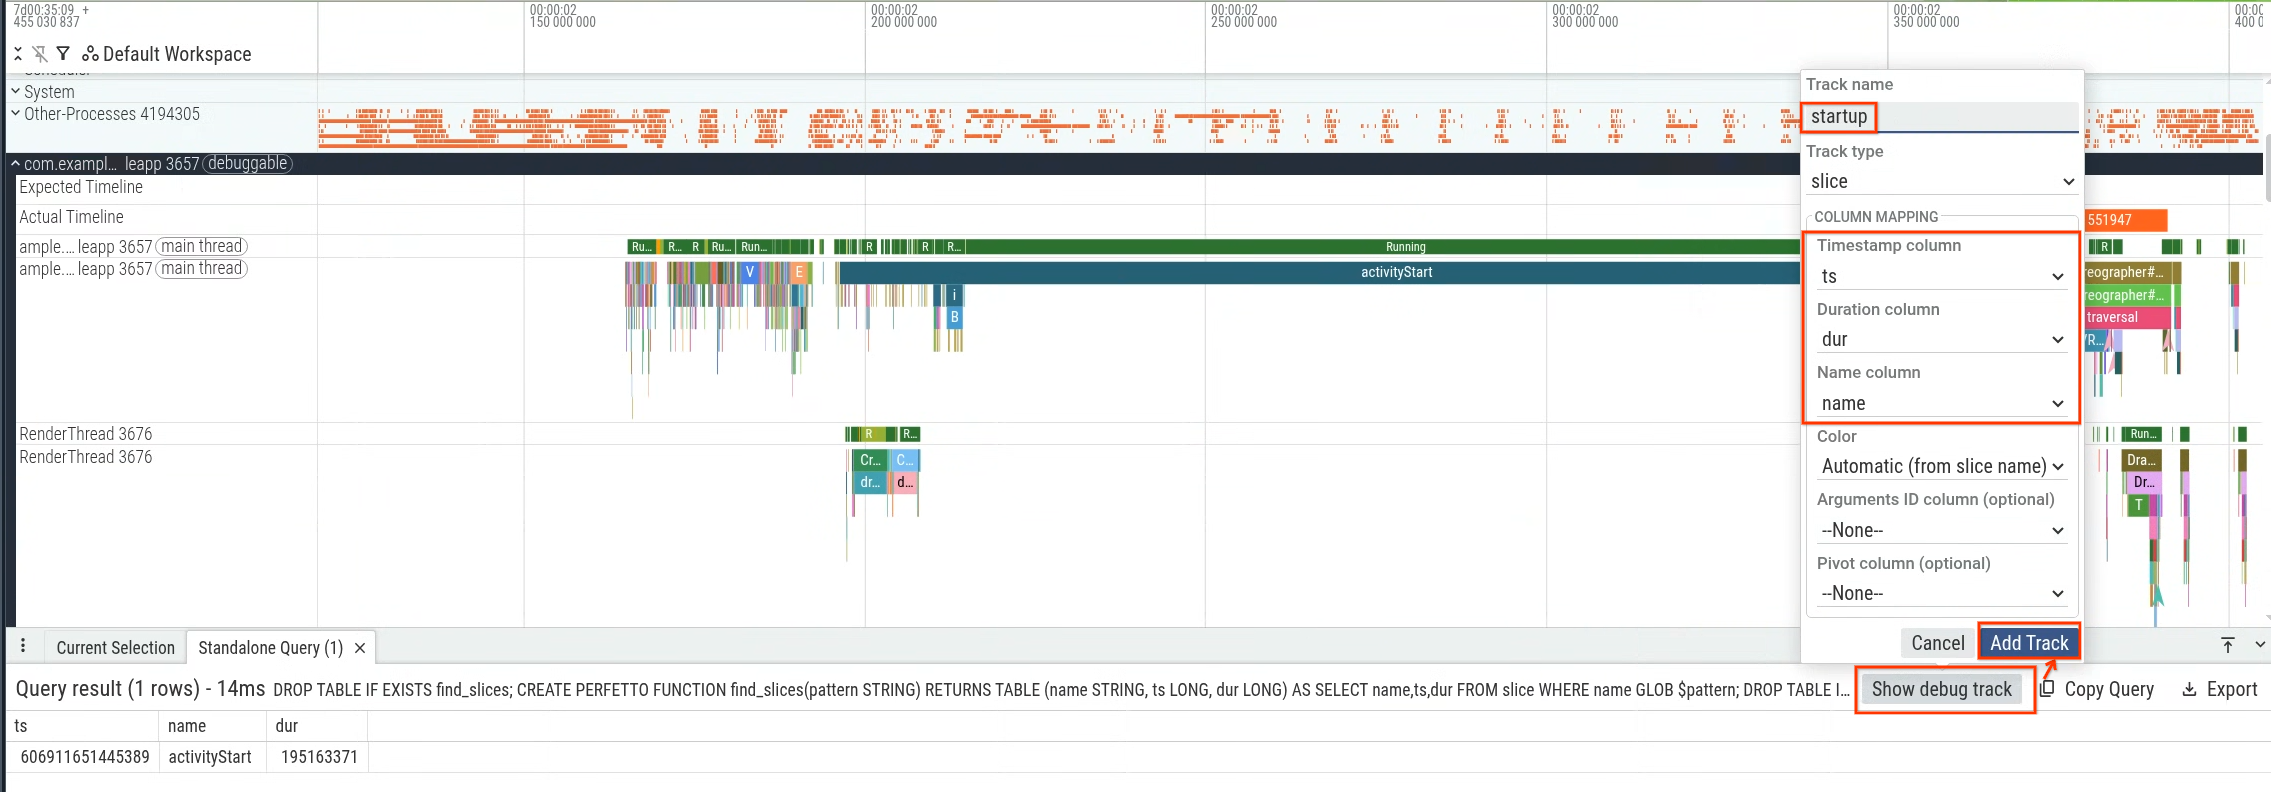
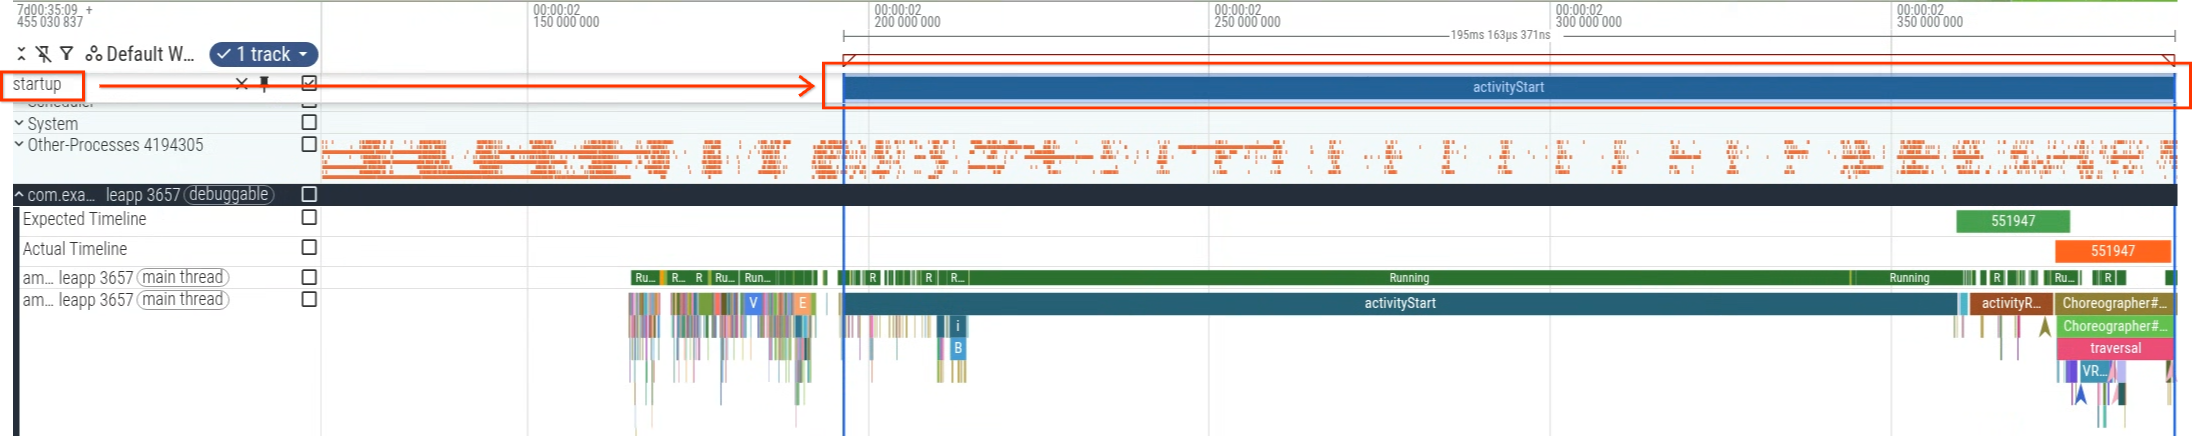
您可以在 Perfetto 界面中执行查询,然后使用查询结果生成调试轨迹(图 2),并在时间轴中直观呈现(图 3)。
设置 Python 环境
在本地机器上安装 Python 及其所需的库:
pip install perfetto pandas plotly
创建批量跟踪分析脚本
以下示例脚本使用 Perfetto 的 Python BatchTraceProcessor 在多个跟踪记录中执行查询。
from perfetto.batch_trace_processor import BatchTraceProcessor
import glob
import plotly.express as px

# Collect all trace files in the local directory
traces = glob.glob('*.perfetto-trace')

if not traces:
    print("No .perfetto-trace files found in the current directory.")
    exit(1)

if __name__ == '__main__':
    # Process all traces in parallel to aggregate metrics across runs
    with BatchTraceProcessor(traces) as btp:
        query = """
        CREATE OR REPLACE PERFETTO FUNCTION find_slices(pattern STRING) RETURNS
        TABLE (name STRING, ts LONG, dur LONG) AS
        SELECT name,ts,dur FROM slice WHERE name GLOB $pattern;

        CREATE OR REPLACE PERFETTO FUNCTION generate_start_to_end_slices(startSlicePattern STRING, endSlicePattern STRING, inclusive BOOL) RETURNS
        TABLE(name STRING, ts LONG, dur LONG) AS
        SELECT name, ts, MIN(startToEndDur) as dur
        FROM
          (SELECT S.name as name, S.ts as ts, E.ts + IIF($inclusive, E.dur, 0) - S.ts as startToEndDur
          FROM find_slices($startSlicePattern) as S CROSS JOIN find_slices($endSlicePattern) as E
          WHERE startToEndDur > 0)
        GROUP BY name, ts;

        SELECT ts,name,dur / 1000000 as dur_ms from generate_start_to_end_slices('activityStart','*Choreographer#doFrame [0-9]*', true)
        """
        df = btp.query_and_flatten(query)
        # Plot the distribution of startup times, tracking trace file paths on
        # hover
        violin = px.violin(df, x='dur_ms', hover_data='_path', title='startup time', points='all')
        violin.show()
了解脚本
运行 Python 脚本时,它会执行以下操作:
- 该脚本会在本地目录中搜索后缀为
.perfetto-trace的所有 Perfetto 轨迹,并将其用作分析的源轨迹。 - 它会运行批量跟踪查询,计算启动时间中对应于从
activityStart跟踪切片到应用生成的第一个帧的时间的子集。 - 它使用小提琴图绘制以毫秒为单位的延迟时间,以直观呈现启动时间的分布情况。
解释结果

执行脚本后,脚本会生成一个图。在这种情况下,图表会显示具有两个明显峰值的双峰分布(图 4)。
接下来,找出两个总体之间的差异。这有助于您更详细地检查各个跟踪记录。在此示例中,图表已设置好,当您将鼠标悬停在数据点(延迟时间)上时,可以识别跟踪文件名。然后,您可以打开高延迟组中的一个跟踪记录。
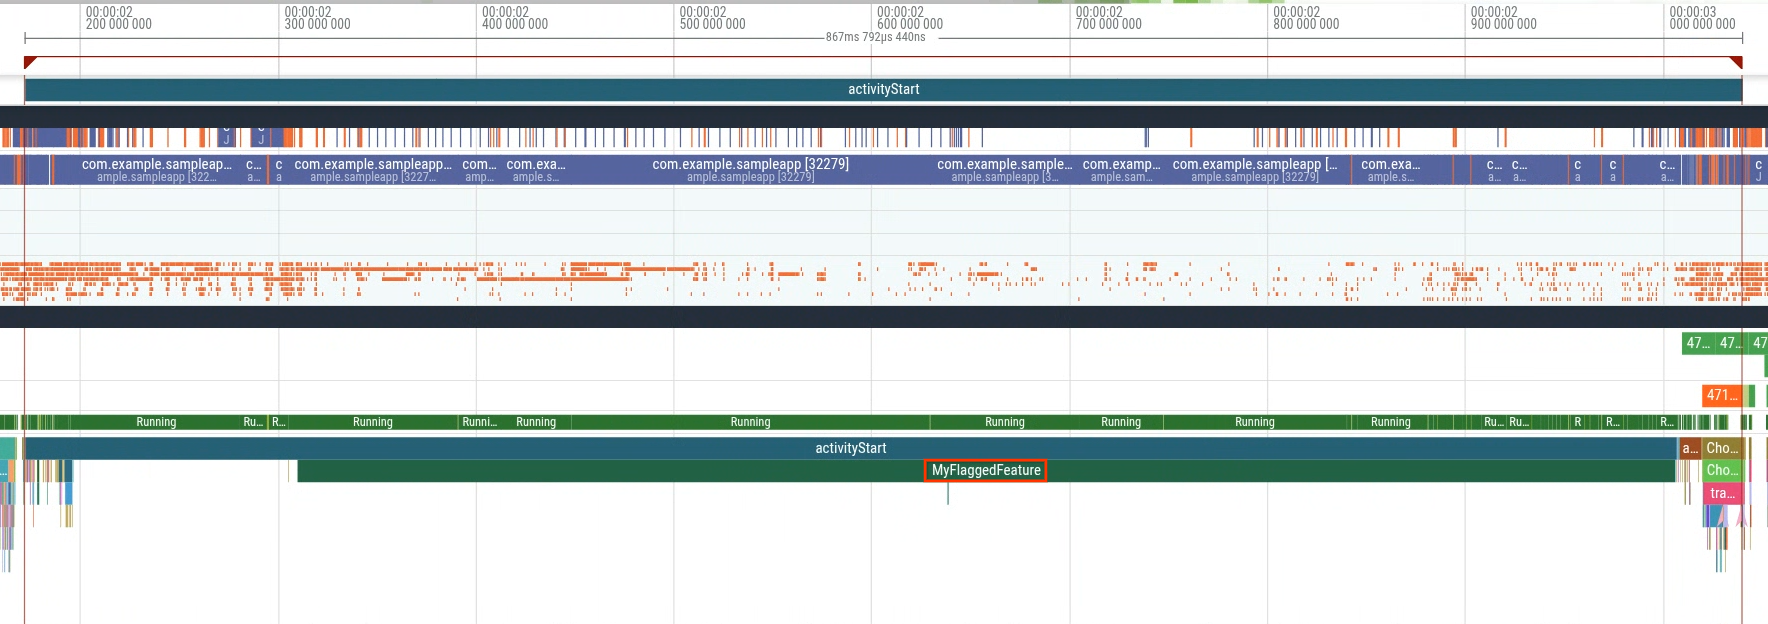
当您打开高延迟组中的跟踪记录(图 5)时,您会发现启动期间运行了一个名为 MyFlaggedFeature 的额外切片(图 6)。
相反,从延迟时间较短的群体(最左侧的峰值)中选择一个跟踪记录,可以确认该切片不存在(图 7)。此比较表明,为一部分用户启用的特定功能标志会触发回归。

此示例演示了使用批量跟踪分析的众多方法之一。 其他应用场景包括从现场提取统计信息以衡量影响、检测回归等。