

ProfilingManager का इस्तेमाल करके कई ट्रेस इकट्ठा करने के बाद, परफ़ॉर्मेंस से जुड़ी समस्याओं का पता लगाने के लिए, उन्हें अलग-अलग एक्सप्लोर करना मुश्किल हो जाता है. बल्क ट्रेस विश्लेषण की मदद से, ट्रेस के डेटासेट को एक साथ क्वेरी किया जा सकता है, ताकि:
- परफ़ॉर्मेंस में आम तौर पर होने वाली गिरावट की पहचान करना.
- सांख्यिकीय डिस्ट्रिब्यूशन का हिसाब लगाना. जैसे, P50, P90, P99 लेटेंसी.
- कई ट्रेस में पैटर्न ढूंढें.
- परफ़ॉर्मेंस की समस्याओं को समझने और उन्हें डीबग करने के लिए, आउटलायर ट्रेस ढूंढें.
इस सेक्शन में, Perfetto Python Batch Trace Processor का इस्तेमाल करने का तरीका बताया गया है. इससे, डिवाइस पर सेव किए गए ट्रेस के सेट में स्टार्टअप मेट्रिक का विश्लेषण किया जा सकता है. साथ ही, ज़्यादा बारीकी से विश्लेषण करने के लिए, आउटलायर ट्रेस का पता लगाया जा सकता है.
क्वेरी डिज़ाइन करना
एक साथ कई डेटा का विश्लेषण करने के लिए, सबसे पहले PerfettoSQL क्वेरी बनाएं.
इस सेक्शन में, हम एक ऐसी क्वेरी का उदाहरण दे रहे हैं जो ऐप्लिकेशन के स्टार्टअप में लगने वाले समय को मेज़र करती है.
खास तौर पर, activityStart से लेकर जनरेट किए गए पहले फ़्रेम (Choreographer#doFrame स्लाइस का पहली बार दिखना) तक की अवधि को मेज़र किया जा सकता है. इससे, ऐप्लिकेशन के स्टार्टअप में लगने वाले समय को मेज़र किया जा सकता है. यह समय, आपके ऐप्लिकेशन के कंट्रोल में होता है. इमेज 1 में, क्वेरी करने के लिए सेक्शन दिखाया गया है.

CREATE OR REPLACE PERFETTO FUNCTION find_slices(pattern STRING) RETURNS
TABLE (name STRING, ts LONG, dur LONG) AS
SELECT name,ts,dur FROM slice WHERE name GLOB $pattern;

CREATE OR REPLACE PERFETTO FUNCTION generate_start_to_end_slices(startSlicePattern STRING, endSlicePattern STRING, inclusive BOOL) RETURNS
TABLE(name STRING, ts LONG, dur LONG) AS
SELECT name, ts, MIN(startToEndDur) as dur
FROM
  (SELECT S.name as name, S.ts as ts, E.ts + IIF($inclusive, E.dur, 0) - S.ts as startToEndDur
  FROM find_slices($startSlicePattern) as S CROSS JOIN find_slices($endSlicePattern) as E
  WHERE startToEndDur > 0)
GROUP BY name, ts;

SELECT ts,name,dur from generate_start_to_end_slices('activityStart','*Choreographer#doFrame [0-9]*', true)
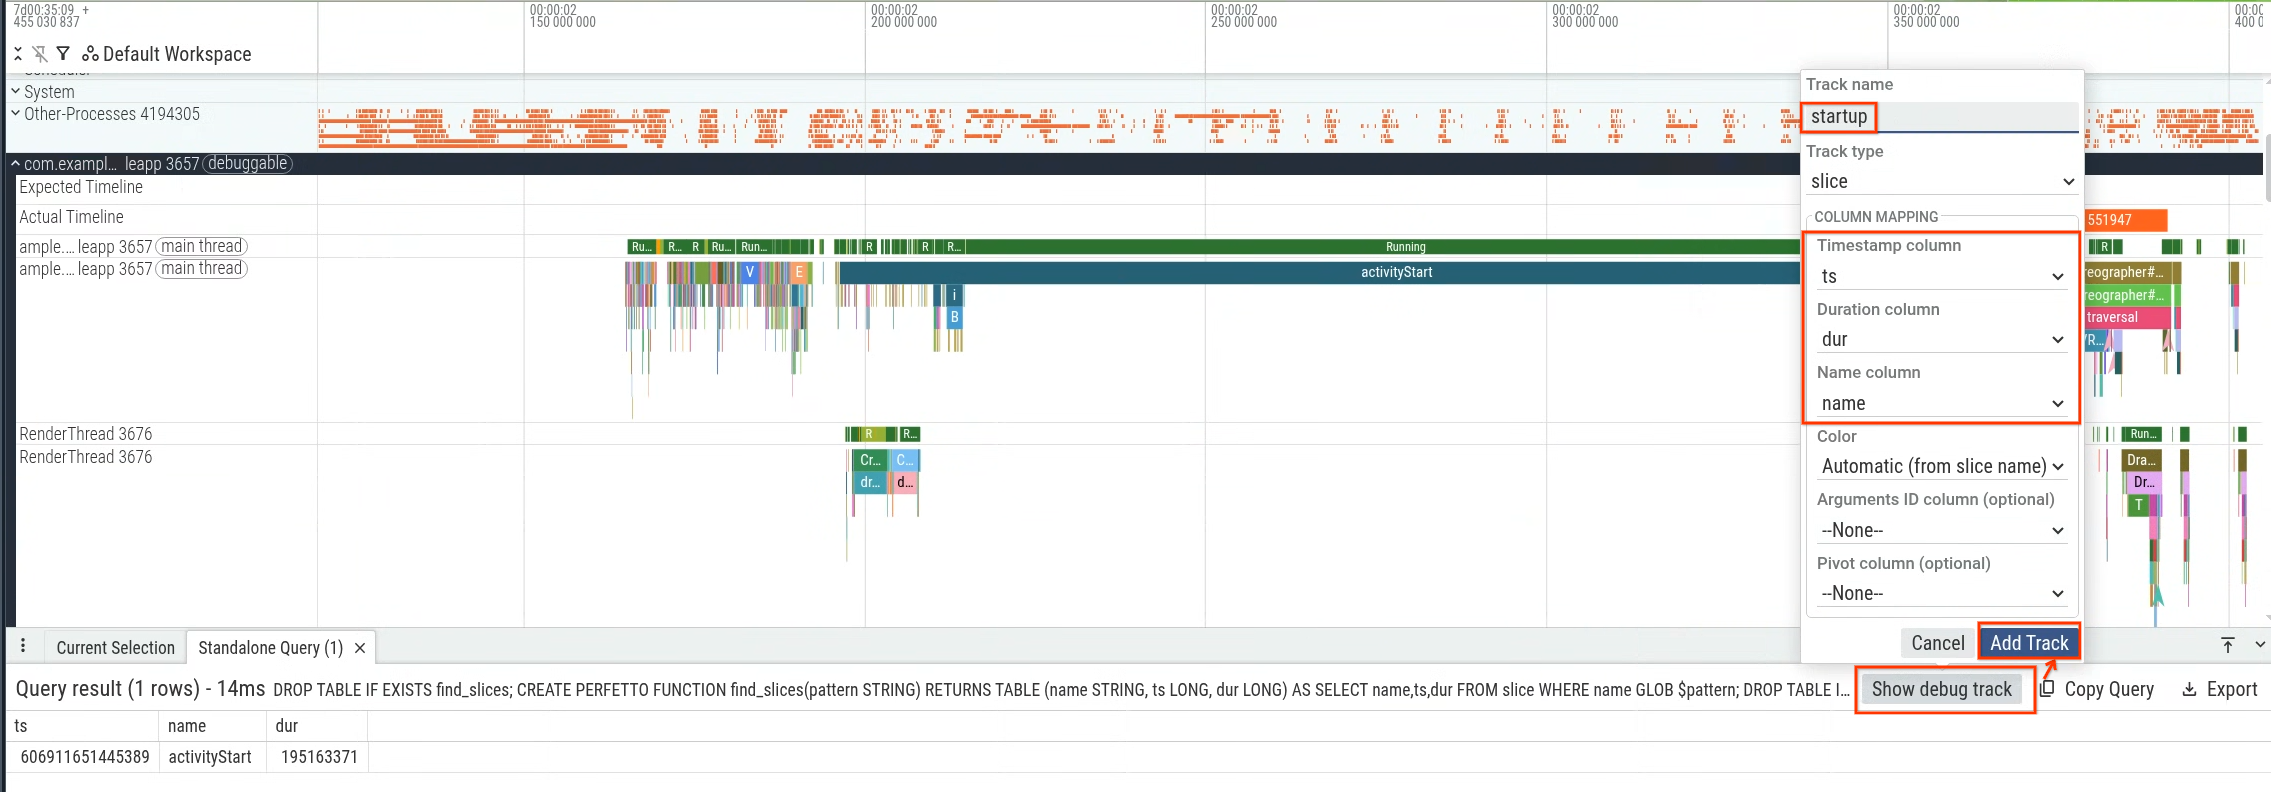
Perfetto यूज़र इंटरफ़ेस (यूआई) में क्वेरी को चलाया जा सकता है. इसके बाद, क्वेरी के नतीजों का इस्तेमाल करके, डीबग ट्रैक जनरेट किया जा सकता है (इमेज 2). साथ ही, इसे टाइमलाइन में विज़ुअलाइज़ किया जा सकता है (इमेज 3).

Python एनवायरमेंट सेट अप करना
अपने कंप्यूटर पर Python इंस्टॉल करें और इसकी ज़रूरी लाइब्रेरी इंस्टॉल करें:
pip install perfetto pandas plotly
एक साथ कई ट्रेस का विश्लेषण करने वाली स्क्रिप्ट बनाना
यहां दी गई सैंपल स्क्रिप्ट, Perfetto के Python BatchTraceProcessor का इस्तेमाल करके, कई ट्रेस में क्वेरी को एक्ज़ीक्यूट करती है.
from perfetto.batch_trace_processor import BatchTraceProcessor
import glob
import plotly.express as px

# Collect all trace files in the local directory
traces = glob.glob('*.perfetto-trace')

if not traces:
    print("No .perfetto-trace files found in the current directory.")
    exit(1)

if __name__ == '__main__':
    # Process all traces in parallel to aggregate metrics across runs
    with BatchTraceProcessor(traces) as btp:
        query = """
        CREATE OR REPLACE PERFETTO FUNCTION find_slices(pattern STRING) RETURNS
        TABLE (name STRING, ts LONG, dur LONG) AS
        SELECT name,ts,dur FROM slice WHERE name GLOB $pattern;

        CREATE OR REPLACE PERFETTO FUNCTION generate_start_to_end_slices(startSlicePattern STRING, endSlicePattern STRING, inclusive BOOL) RETURNS
        TABLE(name STRING, ts LONG, dur LONG) AS
        SELECT name, ts, MIN(startToEndDur) as dur
        FROM
          (SELECT S.name as name, S.ts as ts, E.ts + IIF($inclusive, E.dur, 0) - S.ts as startToEndDur
          FROM find_slices($startSlicePattern) as S CROSS JOIN find_slices($endSlicePattern) as E
          WHERE startToEndDur > 0)
        GROUP BY name, ts;

        SELECT ts,name,dur / 1000000 as dur_ms from generate_start_to_end_slices('activityStart','*Choreographer#doFrame [0-9]*', true)
        """
        df = btp.query_and_flatten(query)
        # Plot the distribution of startup times, tracking trace file paths on
        # hover
        violin = px.violin(df, x='dur_ms', hover_data='_path', title='startup time', points='all')
        violin.show()
स्क्रिप्ट को समझना
Python स्क्रिप्ट को चलाने पर, यह कार्रवाइयां की जाती हैं:
- स्क्रिप्ट, आपकी लोकल डायरेक्ट्री में उन सभी Perfetto ट्रेस को खोजती है जिनके आखिर में
.perfetto-traceलगा होता है. साथ ही, विश्लेषण के लिए उन्हें सोर्स ट्रेस के तौर पर इस्तेमाल करती है. - यह एक बल्क ट्रेस क्वेरी चलाता है, जो ऐप्लिकेशन के चालू होने में लगने वाले समय के सबसेट का हिसाब लगाती है. यह सबसेट,
activityStartट्रेस स्लाइस से लेकर आपके ऐप्लिकेशन से जनरेट किए गए पहले फ़्रेम तक के समय के हिसाब से होता है. - यह वॉयलिन प्लॉट का इस्तेमाल करके, मिलीसेकंड में इंतज़ार का समय दिखाता है. इससे, स्टार्टअप में लगने वाले समय के डिस्ट्रिब्यूशन को विज़ुअलाइज़ किया जा सकता है.
नतीजों को समझना

स्क्रिप्ट को एक्ज़ीक्यूट करने के बाद, स्क्रिप्ट एक प्लॉट जनरेट करती है. इस मामले में, प्लॉट में दो अलग-अलग पीक के साथ बाइमोडल डिस्ट्रिब्यूशन दिखता है (इमेज 4).
इसके बाद, दोनों जनसंख्या के बीच का अंतर पता करें. इससे आपको हर ट्रेस की ज़्यादा जानकारी देखने में मदद मिलती है. इस उदाहरण में, प्लॉट को इस तरह से सेट अप किया गया है कि डेटा पॉइंट (लेटेंसी) पर कर्सर घुमाने पर, ट्रेस फ़ाइल के नाम देखे जा सकते हैं. इसके बाद, ज़्यादा इंतज़ार के समय वाले ग्रुप में शामिल किसी ट्रेस को खोला जा सकता है.
ज़्यादा इंतज़ार के समय वाले ग्रुप (इमेज 5) से ट्रेस खोलने पर, आपको स्टार्टअप के दौरान चलने वाली MyFlaggedFeature नाम की एक अतिरिक्त स्लाइस दिखेगी (इमेज 6).
इसके उलट, कम इंतज़ार के समय वाली पॉप्युलेशन (सबसे बाईं ओर मौजूद पीक) से ट्रेस चुनने पर, यह पुष्टि होती है कि वह स्लाइस मौजूद नहीं है (इमेज 7). इस तुलना से पता चलता है कि उपयोगकर्ताओं के किसी सबसेट के लिए चालू किया गया कोई खास फ़ीचर फ़्लैग, रिग्रेशन को ट्रिगर करता है.


इस उदाहरण में, बल्क ट्रेस ऐनलिसिस का इस्तेमाल करने के कई तरीकों में से एक तरीका बताया गया है. इसके अलावा, इस डेटा का इस्तेमाल करके, असर का आकलन करने के लिए फ़ील्ड से आंकड़े निकाले जा सकते हैं, रिग्रेशन का पता लगाया जा सकता है, और अन्य काम किए जा सकते हैं.