

وقتی چندین ردیابی را بااستفاده از ProfilingManager جمعآوری کردید، کاوش کردن آنها بهصورت جداگانه برای پیدا کردن مشکلات عملکرد غیرعملی میشود. تجزیهوتحلیل ردیابی انبوه به شما امکان میدهد بهطور همزمان از مجموعه دادهای از ردیابیها پُرسمان کنید تا:
- پسرفتهای عملکردی رایج را شناسایی کنید.
- محاسبه توزیعهای آماری (برای مثال، تأخیر P50، P90، P99).
- الگوها را در چندین ردیابی پیدا کنید.
- ردیابیهای پرت را برای درک و اشکالزدایی مشکلات عملکرد پیدا کنید.
این بخش نشان میدهد که چگونه از پردازشگر ردیابی دستهای Perfetto Python برای تجزیهوتحلیل سنجههای راهاندازی در مجموعهای از ردیابیهای ذخیرهشده محلی و یافتن ردیابیهای پرت برای تجزیهوتحلیل عمیقتر استفاده کنید.
طراحی کردن پُرسمان
اولین قدم برای انجام تجزیهوتحلیل انبوه، ایجاد پُرسمان PerfettoSQL است.
در این بخش، نمونه پُرسمانی را ارائه میدهیم که تأخیر راهاندازی برنامه را اندازهگیری میکند.
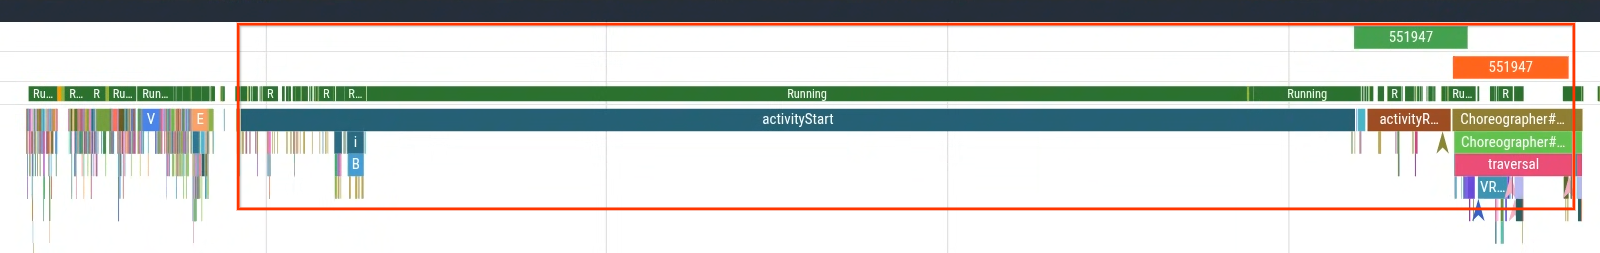
بهطور مشخص، میتوانید مدتزمان از activityStart تا اولین فریم تولیدشده (اولین رخداد برش Choreographer#doFrame) را اندازهگیری کنید تا تأخیر راهاندازی برنامه را که تحت کنترل برنامهتان است اندازهگیری کنید. شکل ۱ بخش موردنظر برای پرسمان را نشان میدهد.
CREATE OR REPLACE PERFETTO FUNCTION find_slices(pattern STRING) RETURNS
TABLE (name STRING, ts LONG, dur LONG) AS
SELECT name,ts,dur FROM slice WHERE name GLOB $pattern;

CREATE OR REPLACE PERFETTO FUNCTION generate_start_to_end_slices(startSlicePattern STRING, endSlicePattern STRING, inclusive BOOL) RETURNS
TABLE(name STRING, ts LONG, dur LONG) AS
SELECT name, ts, MIN(startToEndDur) as dur
FROM
  (SELECT S.name as name, S.ts as ts, E.ts + IIF($inclusive, E.dur, 0) - S.ts as startToEndDur
  FROM find_slices($startSlicePattern) as S CROSS JOIN find_slices($endSlicePattern) as E
  WHERE startToEndDur > 0)
GROUP BY name, ts;

SELECT ts,name,dur from generate_start_to_end_slices('activityStart','*Choreographer#doFrame [0-9]*', true)
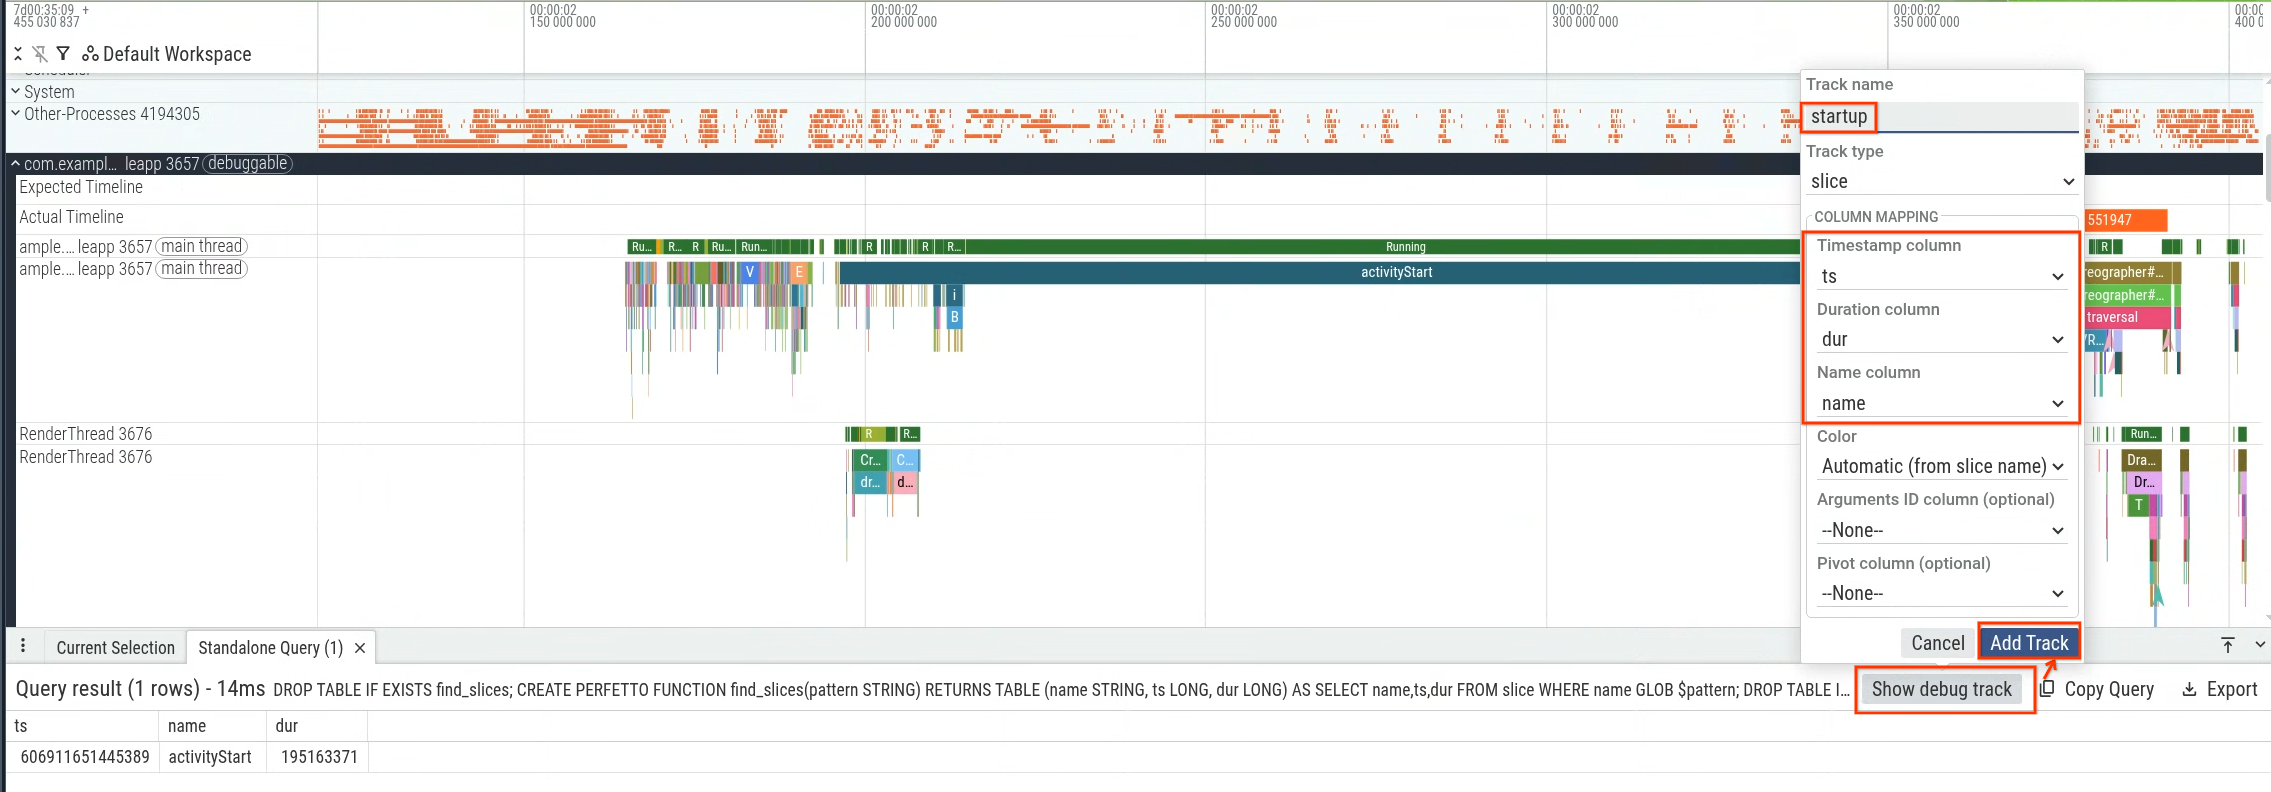
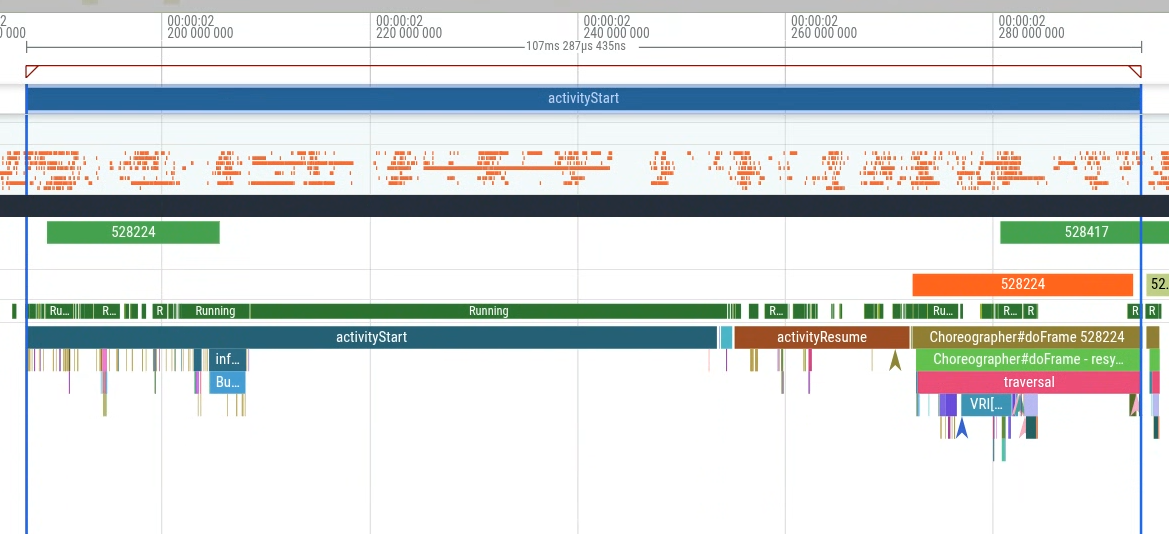
میتوانید پُرسمان را در میانای کاربر Perfetto اجرا کنید و سپس از نتایج پُرسمان برای تولید قطعه اشکالزدایی (شکل ۲) و تجسم آن در خط زمان (شکل ۳) استفاده کنید.

راهاندازی محیط Python
Python و کتابخانههای موردنیاز آن را در ماشین محلیتان نصب کنید:
pip install perfetto pandas plotly
ایجاد کردن اسکریپت تحلیل ردیابی انبوه
نمونه اسکریپت زیر پُرسمان را در چندین ردگیری بااستفاده از
Perfetto Python BatchTraceProcessor اجرا میکند.
from perfetto.batch_trace_processor import BatchTraceProcessor
import glob
import plotly.express as px

# Collect all trace files in the local directory
traces = glob.glob('*.perfetto-trace')

if not traces:
    print("No .perfetto-trace files found in the current directory.")
    exit(1)

if __name__ == '__main__':
    # Process all traces in parallel to aggregate metrics across runs
    with BatchTraceProcessor(traces) as btp:
        query = """
        CREATE OR REPLACE PERFETTO FUNCTION find_slices(pattern STRING) RETURNS
        TABLE (name STRING, ts LONG, dur LONG) AS
        SELECT name,ts,dur FROM slice WHERE name GLOB $pattern;

        CREATE OR REPLACE PERFETTO FUNCTION generate_start_to_end_slices(startSlicePattern STRING, endSlicePattern STRING, inclusive BOOL) RETURNS
        TABLE(name STRING, ts LONG, dur LONG) AS
        SELECT name, ts, MIN(startToEndDur) as dur
        FROM
          (SELECT S.name as name, S.ts as ts, E.ts + IIF($inclusive, E.dur, 0) - S.ts as startToEndDur
          FROM find_slices($startSlicePattern) as S CROSS JOIN find_slices($endSlicePattern) as E
          WHERE startToEndDur > 0)
        GROUP BY name, ts;

        SELECT ts,name,dur / 1000000 as dur_ms from generate_start_to_end_slices('activityStart','*Choreographer#doFrame [0-9]*', true)
        """
        df = btp.query_and_flatten(query)
        # Plot the distribution of startup times, tracking trace file paths on
        # hover
        violin = px.violin(df, x='dur_ms', hover_data='_path', title='startup time', points='all')
        violin.show()
درک کردن دستورگان
وقتی اسکریپت Python را اجرا میکنید، کنشهای زیر را انجام میدهد:
- این اسکریپت در فهرست محلی شما برای همه ردگیریهای Perfetto با پسوند
.perfetto-traceجستجو میکند و از آنها بهعنوان ردگیریهای منبع برای تجزیهوتحلیل استفاده میکند. - این سنجه پُرسمان ردیابی انبوهی را اجرا میکند که زیرمجموعه زمان راهاندازی را محاسبه میکند.
این زیرمجموعه با زمان بین برش ردیابی
activityStartتا اولین قابی که برنامهتان تولید میکند مطابقت دارد. - این ابزار تأخیر را برحسب میلیثانیه بااستفاده از نمودار ویولنی ترسیم میکند تا توزیع زمانهای راهاندازی را تجسم کند.
تفسیر کردن نتایج

پساز اجرای دستورات، دستورات طرحی را تولید میکند. در این مورد، نمودار توزیع دومدی با دو قله متمایز را نشان میدهد (شکل ۴).
سپس، تفاوت بین دو جامعه را پیدا کنید. این کار به شما کمک میکند ردیابیهای تکی را با جزئیات بیشتر بررسی کنید. در این مثال، نمودار بهگونهای تنظیم شده است که وقتی نشانگر را روی نقاط داده (تأخیرها) نگه میدارید، میتوانید نام فایلهای ردیابی را شناسایی کنید. سپس میتوانید یکی از ردیابیهایی را که بخشی از گروه تأخیر بالا است باز کنید.
وقتی ردیابی را از گروه تأخیر بالا باز میکنید (شکل ۵)،
بخش اضافهای بهنام MyFlaggedFeature پیدا خواهید کرد که درطول راهاندازی اجرا میشود (شکل ۶).
برعکس، انتخاب ردیابی از جمعیت با تأخیر کمتر (قله سمت چپ) تأیید میکند که همان برش وجود ندارد (شکل ۷). این مقایسه نشان میدهد که یک پرچم ویژگی خاص، که برای زیرمجموعهای از کاربران فعال شده است، باعث ایجاد رگرسیون میشود.


این مثال یکی از روشهای متعددی را نشان میدهد که میتوانید از تحلیل انبوه ردگیری استفاده کنید. سایر موارد استفاده شامل استخراج آمار از فیلد برای سنجش تأثیر، تشخیص رگرسیون، و موارد دیگر است.