

Aplikacja działająca przede wszystkim offline to aplikacja, która może wykonywać wszystkie lub najważniejsze funkcje bez dostępu do internetu. Oznacza to, że może wykonywać część lub całość logiki biznesowej w trybie offline.
Kwestie, które należy wziąć pod uwagę podczas tworzenia aplikacji działającej przede wszystkim offline, zaczynają się od warstwy danych, która zapewnia dostęp do danych aplikacji i logiki biznesowej. Co jakiś czas aplikacja może wymagać odświeżenia tych danych ze źródeł zewnętrznych. W tym celu może być konieczne wywołanie zasobów sieciowych, aby zachować aktualność.
Dostępność sieci nie zawsze jest gwarantowana. Urządzenia często mają okresy niestabilnego lub wolnego połączenia sieciowego. Użytkownicy mogą zauważyć następujące objawy:
- Ograniczona przepustowość internetu
- chwilowe przerwy w połączeniu, np. w windzie lub tunelu;
- sporadyczny dostęp do danych – na przykład tablety obsługujące tylko sieć Wi-Fi;
Niezależnie od przyczyny aplikacja może często działać prawidłowo w takich okolicznościach. Aby aplikacja działała prawidłowo w trybie offline, musi mieć możliwość:
- zachowanie użyteczności bez niezawodnego połączenia sieciowego,
- Natychmiastowe wyświetlanie użytkownikom danych produktów dostępnych lokalnie zamiast czekania na zakończenie lub niepowodzenie pierwszego wywołania sieciowego.
- pobierać dane w sposób uwzględniający stan baterii i transmisji danych – na przykład żądać pobrania danych tylko w optymalnych warunkach, takich jak ładowanie lub połączenie z Wi-Fi;
Aplikacja, która spełnia te kryteria, jest często nazywana aplikacją działającą przede wszystkim offline.
Projektowanie aplikacji działającej przede wszystkim offline
Projektując aplikację działającą przede wszystkim offline, zacznij od warstwy danych i 2 głównych operacji, które możesz wykonywać na danych aplikacji:
- Odczyty: pobieranie danych do wykorzystania przez inne części aplikacji, np. do wyświetlania informacji użytkownikowi. W Compose zwykle osiąga się to przez obserwowanie stanu. Gdy interfejs obserwuje lokalne źródło danych jako stan, ekran automatycznie odzwierciedla najnowsze dane produktów dostępnych lokalnie.
- Zapisy: utrwalanie danych wejściowych użytkownika w celu ich późniejszego pobrania. W Compose zwykle osiąga się to za pomocą zdarzeń i działań wysyłanych z interfejsu do ViewModel.
Repozytoria w warstwie danych odpowiadają za łączenie źródeł danych w celu dostarczania danych aplikacji. W aplikacji działającej przede wszystkim offline musi być co najmniej 1 źródło danych, które nie wymaga dostępu do sieci, aby wykonywać najważniejsze zadania. Jednym z tych kluczowych zadań jest odczytywanie danych.
Modelowanie danych w aplikacji działającej głównie offline
Aplikacja działająca przede wszystkim offline ma co najmniej 2 źródła danych dla każdego repozytorium, które korzysta z zasobów sieciowych:
- lokalne źródło danych,
- Źródło danych sieciowych
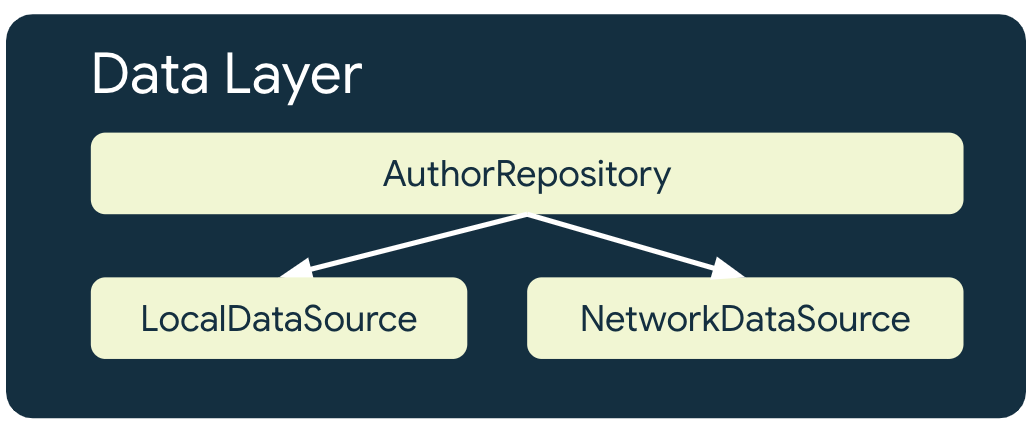
lokalne źródło danych,
Lokalne źródło danych jest kanonicznym źródłem informacji dla aplikacji. Powinno być wyłącznym źródłem danych odczytywanych przez wyższe warstwy aplikacji. Zapewnia to spójność danych między stanami połączenia. Lokalne źródło danych jest często obsługiwane przez pamięć masową, która jest zapisywana na dysku. Oto kilka typowych sposobów zapisywania danych na dysku:
- uporządkowane źródła danych, takie jak relacyjne bazy danych, np. Room;
- nieuporządkowane źródła danych, np. bufor protokołu z magazynem danych;
- Proste pliki
Źródło danych sieciowych
Źródło danych sieciowych to rzeczywisty stan aplikacji. W najlepszym przypadku lokalne źródło danych jest synchronizowane ze źródłem danych w sieci. Dane produktów dostępnych lokalnie mogą też być opóźnione w stosunku do sieciowego źródła danych. W takim przypadku aplikacja musi zostać zaktualizowana po ponownym połączeniu z internetem. I odwrotnie – sieciowe źródło danych może być opóźnione względem danych produktów dostępnych lokalnie, dopóki aplikacja nie zaktualizuje go po przywróceniu połączenia. Warstwy domeny i interfejsu aplikacji nie mogą nigdy komunikować się bezpośrednio z warstwą sieciową. Za komunikację z nim i używanie go do aktualizowania lokalnego źródła danych odpowiada hostujący repository.
Synchronizacja niestandardowa a zarządzana
Warstwę danych działającą przede wszystkim offline można utworzyć na 2 główne sposoby:
- Niestandardowy stos synchronizacji: utrzymujesz lokalne bazy danych za pomocą Room lub plików w pamięci lokalnej, tworzysz niestandardowych klientów sieci i planujesz pracowników uzgadniania za pomocą WorkManagera. Takie podejście zapewnia maksymalną kontrolę nad schematami i niestandardowymi algorytmami rozwiązywania konfliktów.
- Zarządzane usługi w chmurze: rozwiązania takie jak Cloud Firestore mogą zapewnić kompleksową lokalną pamięć podręczną i strumień w chmurze w czasie rzeczywistym. Pakiet SDK automatycznie obsługuje pamięć podręczną na dysku, kolejkowanie zapisu offline i dwukierunkową synchronizację, dostarczając strumienie danych w czasie rzeczywistym bezpośrednio do repozytorium. W przypadku relacyjnych backendów PostgreSQL Firebase SQL Connect generuje pakiety SDK klienta Kotlin z zabezpieczeniami wpisywania, które bezproblemowo integrują się z Twoimi repozytoriami. W przypadku danych nieuporządkowanych (takich jak multimedia, duże pliki czy kopie zapasowe) Cloud Storage dla Firebase zapewnia przechowywanie obiektów w chmurze z operacjami przesyłania i pobierania, które są automatycznie wstrzymywane i wznawiane w przypadku przerw w działaniu sieci.
Udostępnianie zasobów
Lokalne i sieciowe źródła danych mogą się zasadniczo różnić pod względem sposobu, w jaki aplikacja może je odczytywać i zapisywać. Wysyłanie zapytań do lokalnego źródła danych może być szybkie i elastyczne, na przykład gdy używasz zapytań SQL. Z kolei sieciowe źródła danych mogą być powolne i ograniczone, np. gdy uzyskujesz dostęp do zasobów RESTful według identyfikatora. W związku z tym każde źródło danych często wymaga własnej reprezentacji danych, które dostarcza. Lokalne źródło danych produktów dostępnych lokalnie i sieciowe źródło danych mogą więc mieć własne modele.
Tę koncepcję ilustruje poniższa struktura katalogów. AuthorEntity reprezentuje autora odczytanego z lokalnej bazy danych aplikacji, a NetworkAuthor – autora zserializowanego w sieci:
data/
├─ local/
│ ├─ entities/
│ │ ├─ AuthorEntity
│ ├─ dao/
│ ├─ NiADatabase
├─ network/
│ ├─ NiANetwork
│ ├─ models/
│ │ ├─ NetworkAuthor
├─ model/
│ ├─ Author
├─ repository/
Oto szczegóły dotyczące plików AuthorEntity i NetworkAuthor:
/**
 * Network representation of [Author]
 */
@Serializable
data class NetworkAuthor(
    val id: String,
    val name: String,
    val imageUrl: String,
    val twitter: String,
    val mediumPage: String,
    val bio: String,
)

/**
 * Defines an author for either an [EpisodeEntity] or [NewsResourceEntity].
 * It has a many-to-many relationship with both entities
 */
@Entity(tableName = "authors")
data class AuthorEntity(
    @PrimaryKey
    val id: String,
    val name: String,
    @ColumnInfo(name = "image_url")
    val imageUrl: String,
    @ColumnInfo(defaultValue = "")
    val twitter: String,
    @ColumnInfo(name = "medium_page", defaultValue = "")
    val mediumPage: String,
    @ColumnInfo(defaultValue = "")
    val bio: String,
)
Sprawdzoną metodą jest zachowanie zarówno AuthorEntity, jak i NetworkAuthor w warstwie danych i udostępnienie trzeciego typu do wykorzystania przez warstwy zewnętrzne. Dzięki temu warstwy zewnętrzne są chronione przed niewielkimi zmianami w lokalnych i sieciowych źródłach danych, które nie zmieniają zasadniczo działania aplikacji.
Pokazuje to ten fragment kodu:
/**
 * External data layer representation of a "Now in Android" Author
 */
data class Author(
    val id: String,
    val name: String,
    val imageUrl: String,
    val twitter: String,
    val mediumPage: String,
    val bio: String,
)
Model sieciowy może następnie zdefiniować metodę rozszerzenia, aby przekonwertować go na model lokalny, a model lokalny ma podobną metodę, aby przekonwertować go na reprezentację zewnętrzną, jak pokazano w tym fragmencie kodu:
/**
 * Converts the network model to the local model for persisting
 * by the local data source
 */
fun NetworkAuthor.asEntity() = AuthorEntity(
    id = id,
    name = name,
    imageUrl = imageUrl,
    twitter = twitter,
    mediumPage = mediumPage,
    bio = bio,
)

/**
 * Converts the local model to the external model for use
 * by layers external to the data layer
 */
fun AuthorEntity.asExternalModel() = Author(
    id = id,
    name = name,
    imageUrl = imageUrl,
    twitter = twitter,
    mediumPage = mediumPage,
    bio = bio,
)
Odczyty
Odczyty to podstawowa operacja na danych aplikacji w aplikacji działającej przede wszystkim w trybie offline. Musisz więc upewnić się, że aplikacja może odczytywać dane i że gdy tylko pojawią się nowe dane, aplikacja może je wyświetlić. Aplikacja, która może to zrobić, jest aplikacją reaktywną, ponieważ udostępnia interfejsy API do odczytu z obserwowalnymi typami.
We fragmencie poniżej OfflineFirstTopicRepository zwraca Flow dla wszystkich interfejsów API odczytu. Dzięki temu może aktualizować czytniki, gdy otrzymuje aktualizacje ze źródła danych sieci. Innymi słowy, umożliwia OfflineFirstTopicRepository przekazywanie zmian, gdy lokalne dane produktów dostępnych lokalnie zostaną unieważnione. Dlatego każdy czytnik OfflineFirstTopicRepository musi być przygotowany do obsługi zmian danych, które mogą zostać wywołane po przywróceniu połączenia sieciowego z aplikacją. Ponadto OfflineFirstTopicRepository odczytuje dane produktów dostępnych lokalnie bezpośrednio z lokalnego źródła danych. Może powiadamiać czytelników o zmianach danych tylko przez wcześniejsze zaktualizowanie lokalnego źródła danych.
class TopicsViewModel(
    offlineFirstTopicsRepository: OfflineFirstTopicsRepository
) : ViewModel() {

    val topics: StateFlow<List<Topic>> = offlineFirstTopicsRepository.getTopicsStream()
        .stateIn(
            scope = viewModelScope,
            started = SharingStarted.WhileSubscribed(5_000),
            initialValue = emptyList()
        )
}
W aplikacji Jetpack Compose użyj ViewModel, aby połączyć warstwę danych z interfejsem.
W klasie ViewModel przekonwertuj Flow na StateFlow za pomocą operatora stateIn. Następnie elementy kompozycyjne zbierają te stany za pomocą collectAsStateWithLifecycle() i automatycznie zarządzają subskrypcjami w sposób uwzględniający cykl życia.
Więcej informacji o collectAsStateWithLifecycle() znajdziesz w artykule Stan i Jetpack Compose.
Strategie obsługi błędów
W aplikacjach działających przede wszystkim offline błędy są obsługiwane w unikalny sposób, w zależności od źródeł danych, w których mogą wystąpić. W kolejnych sekcjach opisujemy te strategie.
Lokalne źródło danych
Staraj się minimalizować błędy podczas odczytu z lokalnego źródła danych. Aby chronić czytniki przed błędami, użyj operatora catch na obiektach Flow, z których czytnik zbiera dane.
Możesz użyć operatora catch w ViewModel w ten sposób:
class AuthorViewModel(
    authorsRepository: AuthorsRepository,
    ...
) : ViewModel() {
   private val authorId: String = ...

   // Observe author information
    private val authorStream: Flow<Author> =
        authorsRepository.getAuthorStream(
            id = authorId
        )
        .catch { emit(Author.empty()) }
}
Aby uzyskać bardziej odporne rozwiązanie, rozważ rozwiązanie LCE (błąd wczytywania treści). W przypadku LCE, gdy wystąpi błąd podczas odczytu, wyświetlany jest stan błędu. Zwykle LCE osiąga się przez modelowanie stanów interfejsu jako klas zapieczętowanych w języku Kotlin.
// Define the LCE UI state
sealed interface AuthorUiState {
    data object Loading : AuthorUiState
    data class Success(val author: Author) : AuthorUiState
    data object Error : AuthorUiState
}

class AuthorViewModel(
    authorsRepository: AuthorsRepository,
    ...
) : ViewModel() {
    private val authorId: String = ...

    // Observe author information and map to LCE state
    val authorUiState: StateFlow<AuthorUiState> =
        authorsRepository.getAuthorStream(id = authorId)
            .map<Author, AuthorUiState> { author ->
                AuthorUiState.Success(author)
            }
            .catch { emit(AuthorUiState.Error) }
            .stateIn(
                scope = viewModelScope,
                started = SharingStarted.WhileSubscribed(5_000),
                initialValue = AuthorUiState.Loading
            )
}
Źródło danych sieci
Jeśli podczas odczytywania danych ze źródła danych sieciowych wystąpią błędy, aplikacja musi zastosować heurystykę, aby ponowić próbę pobrania danych. Do typowych heurystyk należą:
Wzrastający czas do ponowienia
W przypadku wzrastającego czasu do ponowienia aplikacja próbuje odczytać dane ze źródła danych w sieci w coraz dłuższych odstępach czasu, aż do momentu, gdy się to uda lub gdy inne warunki wymuszą zatrzymanie.
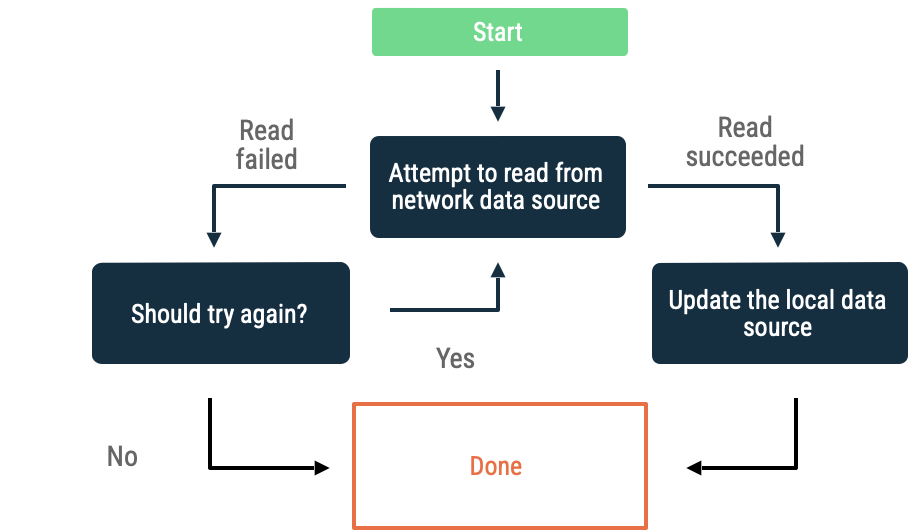
Kryteria oceny, czy aplikacja nadal się wycofuje, obejmują:
- Rodzaj błędu wskazanego przez źródło danych sieci. Na przykład ponawiaj wywołania sieciowe, które zwracają błąd wskazujący na brak połączenia. Nie ponawiaj żądań HTTP, które nie są autoryzowane, dopóki nie będą dostępne odpowiednie dane logowania.
- Maksymalna dozwolona liczba ponownych prób.
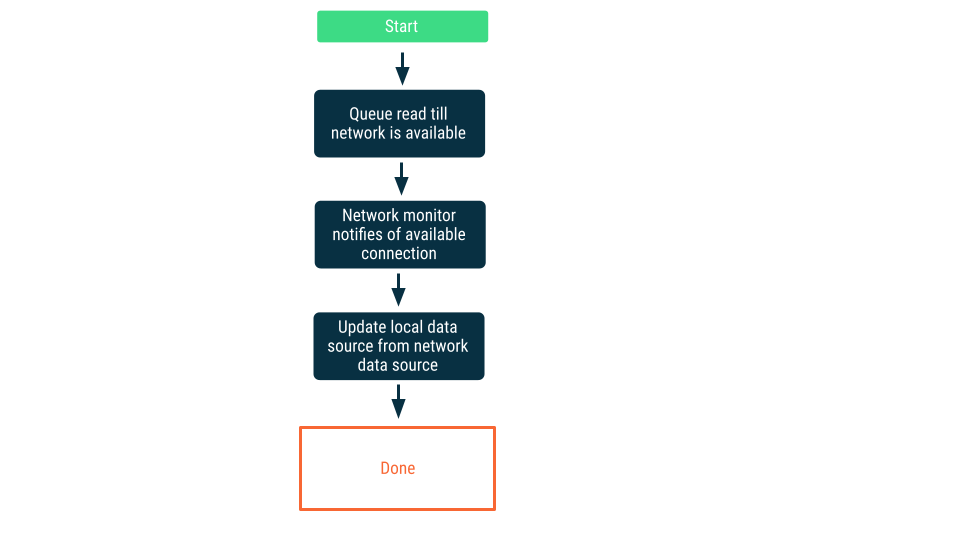
Monitorowanie połączeń sieciowych
W tym podejściu żądania odczytu są umieszczane w kolejce, dopóki aplikacja nie będzie pewna, że może połączyć się ze źródłem danych sieciowych. Po nawiązaniu połączenia żądanie odczytu jest usuwane z kolejki, dane produktów dostępnych lokalnie są odczytywane, a lokalne źródło danych jest aktualizowane. Na Androidzie ta kolejka może być utrzymywana za pomocą bazy danych Room i opróżniana jako trwałe zadanie za pomocą WorkManagera.
Zapisy
Zalecanym sposobem odczytywania danych w aplikacji działającej przede wszystkim offline jest używanie typów obserwowalnych, natomiast odpowiednikiem interfejsów API do zapisu są asynchroniczne interfejsy API, takie jak funkcje zawieszania. Pozwala to uniknąć blokowania wątku UI i ułatwia obsługę błędów, ponieważ zapisy w aplikacjach działających przede wszystkim offline mogą się nie powieść, gdy przekroczą granicę sieci.
interface UserDataRepository {
    /**
     * Updates the bookmarked status for a news resource
     */
    suspend fun updateNewsResourceBookmark(newsResourceId: String, bookmarked: Boolean)
}
We fragmencie powyżej wybranym asynchronicznym interfejsem API są współprogramy, ponieważ metoda jest zawieszana.
Strategie pisania
Podczas zapisywania danych w aplikacjach działających przede wszystkim offline należy wziąć pod uwagę 3 strategie. Wybór zależy od typu zapisywanych danych i wymagań aplikacji:
Zapisy tylko online
Próba zapisania danych poza granicą sieci. Jeśli się powiedzie, zaktualizuj lokalne źródło danych. W przeciwnym razie zgłoś wyjątek i pozostaw odpowiednią reakcję wywołującemu.
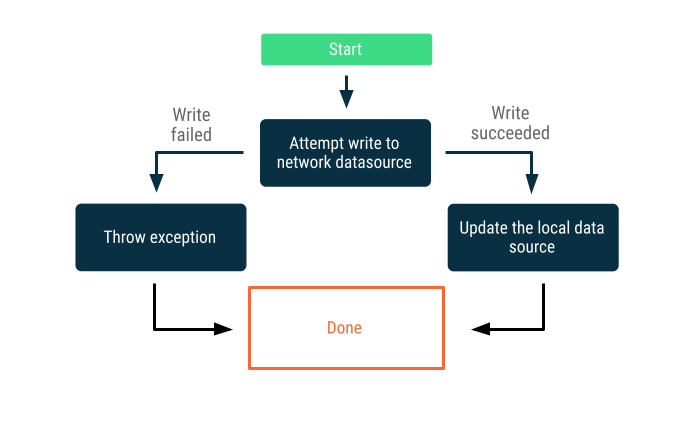
Ta strategia jest często używana w przypadku transakcji zapisu, które muszą odbywać się online w czasie zbliżonym do rzeczywistego, np. przelewów bankowych. Ponieważ zapisywanie może się nie powieść, często konieczne jest poinformowanie użytkownika o niepowodzeniu zapisu lub uniemożliwienie mu próby zapisania danych. Oto kilka strategii, które możesz zastosować w takich sytuacjach:
- Jeśli aplikacja wymaga dostępu do internetu, aby zapisywać dane, możesz nie wyświetlać użytkownikowi interfejsu, który umożliwia zapisywanie danych, lub przynajmniej go wyłączyć.
- Aby powiadomić użytkownika, że jest offline, możesz użyć elementu
AlertDialog, którego użytkownik nie może zamknąć, lub elementuSnackbar.
Zapisy w kolejce
Gdy masz obiekt, który chcesz zapisać, wstaw go do kolejki. Gdy aplikacja ponownie połączy się z internetem, opróżnij kolejkę, stosując wzrastający czas do ponowienia. Na Androidzie opróżnianie kolejki offline to trwałe zadanie, które często jest przekazywane do WorkManagera.
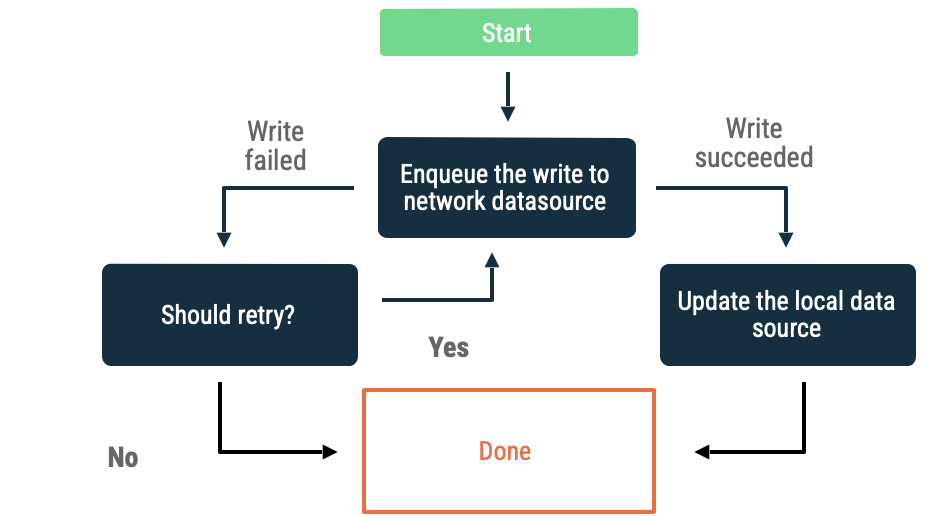
To podejście jest dobrym wyborem w tych sytuacjach:
- Nie jest konieczne, aby dane były zapisywane w sieci.
- Transakcja nie jest pilna.
- Nie jest konieczne informowanie użytkownika o niepowodzeniu operacji.
Takie podejście sprawdza się m.in. w przypadku zdarzeń analitycznych i logowania.
Opóźnione zapisy
Najpierw zapisz dane produktów dostępnych lokalnie w lokalnym źródle danych, a następnie dodaj zapis do kolejki, aby powiadomić sieć przy najbliższej okazji. Nie jest to proste, ponieważ po ponownym połączeniu aplikacji z siecią mogą wystąpić konflikty między siecią a lokalnymi źródłami danych. Więcej informacji znajdziesz w następnej sekcji dotyczącej rozwiązywania konfliktów.
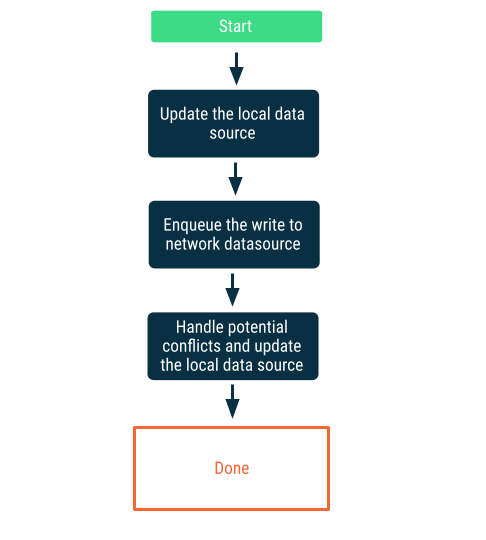
To podejście jest właściwym wyborem, gdy dane są kluczowe dla aplikacji. Na przykład w aplikacji z listą zadań, która działa przede wszystkim offline, ważne jest, aby wszystkie zadania dodane przez użytkownika offline były przechowywane lokalnie, aby uniknąć ryzyka utraty danych.
Synchronizacja i rozwiązywanie konfliktów
Gdy aplikacja działająca przede wszystkim offline odzyska połączenie, musi uzgodnić dane w lokalnym źródle danych z danymi w sieciowym źródle danych. Ten proces nazywa się synchronizacją. Aplikacja może synchronizować się z sieciowym źródłem danych na 2 główne sposoby:
- Synchronizacja oparta na pobieraniu
- Synchronizacja oparta na push
Synchronizacja oparta na pobieraniu
W przypadku synchronizacji opartej na pobieraniu aplikacja łączy się z siecią, aby na żądanie odczytać najnowsze dane aplikacji. Typowa heurystyka tego podejścia opiera się na nawigacji, gdzie aplikacja pobiera dane tylko tuż przed ich wyświetleniem użytkownikowi.
Ta metoda sprawdza się najlepiej, gdy aplikacja oczekuje krótkich lub średnich okresów braku połączenia sieciowego. Dzieje się tak, ponieważ odświeżanie danych jest oportunistyczne, a długie okresy braku połączenia zwiększają prawdopodobieństwo, że użytkownik spróbuje odwiedzić miejsca docelowe aplikacji z nieaktualną lub pustą pamięcią podręczną.
Wyobraź sobie aplikację, w której tokeny stron są używane do pobierania elementów na liście z nieskończonym przewijaniem na konkretnym ekranie. Implementacja może leniwie łączyć się z siecią, zapisywać dane w lokalnym źródle danych, a następnie odczytywać je z lokalnego źródła danych, aby wyświetlać informacje użytkownikowi. Jeśli nie ma połączenia sieciowego, repozytorium może żądać danych produktów dostępnych lokalnie tylko z lokalnego źródła danych. Ten wzorzec jest używany przez bibliotekę Jetpack Paging z interfejsem API RemoteMediator.
class FeedRepository(...) {

    fun feedPagingSource(): PagingSource<FeedItem> { ... }
}

class FeedViewModel(
    private val repository: FeedRepository
) : ViewModel() {
    private val pager = Pager(
        config = PagingConfig(
            pageSize = NETWORK_PAGE_SIZE,
            enablePlaceholders = false
        ),
        remoteMediator = FeedRemoteMediator(...),
        pagingSourceFactory = feedRepository::feedPagingSource
    )

    val feedPagingData = pager.flow
}
Zalety i wady synchronizacji opartej na pobieraniu zostały podsumowane w tej tabeli:
| Zalety | Wady |
|---|---|
| Stosunkowo łatwe do wdrożenia. | Może powodować duże zużycie danych. Dzieje się tak, ponieważ powtarzające się wizyty w miejscu docelowym nawigacji powodują niepotrzebne ponowne pobieranie niezmienionych informacji. Możesz temu zapobiec, stosując odpowiednie buforowanie. Można to zrobić w warstwie interfejsu za pomocą operatora cachedIn lub w warstwie sieciowej za pomocą pamięci podręcznej HTTP. |
| Dane, które nie są potrzebne, nigdy nie są pobierane. | Nie skaluje się dobrze z danymi relacyjnymi, ponieważ pobrany model musi być samowystarczalny. Jeśli synchronizowany model zależy od innych modeli, które muszą zostać pobrane, aby go wypełnić, wspomniany wcześniej problem z dużym wykorzystaniem danych staje się jeszcze poważniejszy. Może to też powodować zależności między repozytoriami modelu nadrzędnego i repozytoriami modelu zagnieżdżonego. |
Synchronizacja oparta na push
W przypadku synchronizacji opartej na modelu push lokalne źródło danych stara się jak najlepiej naśladować zestaw replik sieciowego źródła danych. Przy pierwszym uruchomieniu pobiera odpowiednią ilość danych, aby określić punkt odniesienia. Następnie polega na powiadomieniach z serwera, które informują, że dane są nieaktualne.
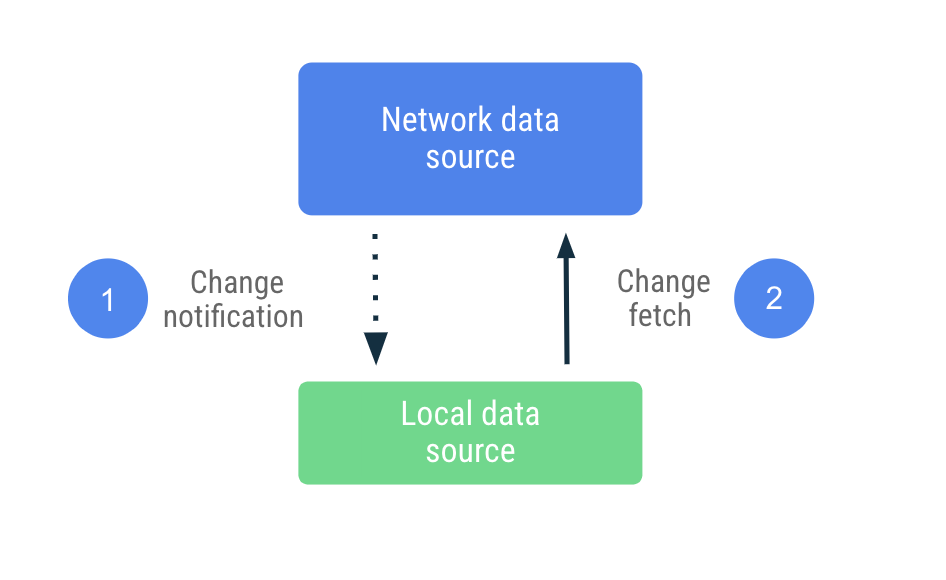
Po otrzymaniu powiadomienia o nieaktualnych danych aplikacja łączy się z siecią, aby zaktualizować tylko te dane, które zostały oznaczone jako nieaktualne. To zadanie jest przekazywane do klasy Repository, która kontaktuje się z sieciowym źródłem danych i zapisuje pobrane dane w lokalnym źródle danych. Repozytorium udostępnia dane za pomocą typów obserwowalnych, więc czytelnicy są powiadamiani o wszelkich zmianach.
class UserDataRepository(...) {

    suspend fun synchronize() {
        val userData = networkDataSource.fetchUserData()
        localDataSource.saveUserData(userData)
    }
}
W tym podejściu aplikacja jest znacznie mniej zależna od sieciowego źródła danych i może działać bez niego przez dłuższy czas. Zapewnia dostęp do odczytu i zapisu w trybie offline, ponieważ zakłada, że ma lokalnie najnowsze informacje ze źródła danych sieciowych.
Zalety i wady synchronizacji opartej na przekazywaniu zostały podsumowane w tej tabeli:
| Zalety | Wady |
|---|---|
| Aplikacja może pozostać offline przez nieograniczony czas. | Wersjonowanie danych na potrzeby rozwiązywania konfliktów nie jest proste. |
| Minimalne wykorzystanie danych. Aplikacja pobiera tylko dane, które uległy zmianie. | Podczas synchronizacji musisz wziąć pod uwagę kwestie związane z zapisem. |
| Dobrze sprawdza się w przypadku danych relacyjnych. Każde repozytorium odpowiada za pobieranie danych tylko dla obsługiwanego przez siebie modelu. | Źródło danych sieci musi obsługiwać synchronizację. |
Synchronizacja hybrydowa
Niektóre aplikacje korzystają z podejścia hybrydowego, które opiera się na modelu pull lub push w zależności od danych. Na przykład aplikacja społecznościowa może używać synchronizacji opartej na pobieraniu, aby pobierać na żądanie kanał obserwowanych użytkowników ze względu na dużą częstotliwość aktualizacji kanału. Ta sama aplikacja może zdecydować się na użycie synchronizacji opartej na powiadomieniach push w przypadku danych o zalogowanym użytkowniku, takich jak nazwa użytkownika, zdjęcie profilowe itp.
Ostatecznie wybór synchronizacji offline-first zależy od wymagań produktu i dostępnej infrastruktury technicznej.
Rozwiązywanie konfliktów
Jeśli aplikacja w trybie offline zapisuje lokalnie dane, które nie są zgodne ze źródłem danych sieci, przed synchronizacją musisz rozwiązać ten konflikt.
Rozwiązywanie konfliktów często wymaga obsługi wersji. Aplikacja musi wykonywać pewne czynności księgowe, aby śledzić, kiedy nastąpiły zmiany, i przekazywać metadane do sieciowego źródła danych. Źródło danych sieciowych jest wtedy odpowiedzialne za dostarczanie bezwzględnego źródła prawdy. Istnieje wiele strategii rozwiązywania konfliktów, które można rozważyć w zależności od potrzeb aplikacji. W przypadku aplikacji mobilnych powszechnym podejściem jest „ostatni zapis wygrywa”.
Wygrywa ostatni zapis
W tym podejściu urządzenia dołączają metadane sygnatury czasowej do danych, które zapisują w sieci. Gdy źródło danych sieciowych je otrzyma, odrzuci wszystkie dane starsze niż jego bieżący stan, a zaakceptuje te, które są nowsze.
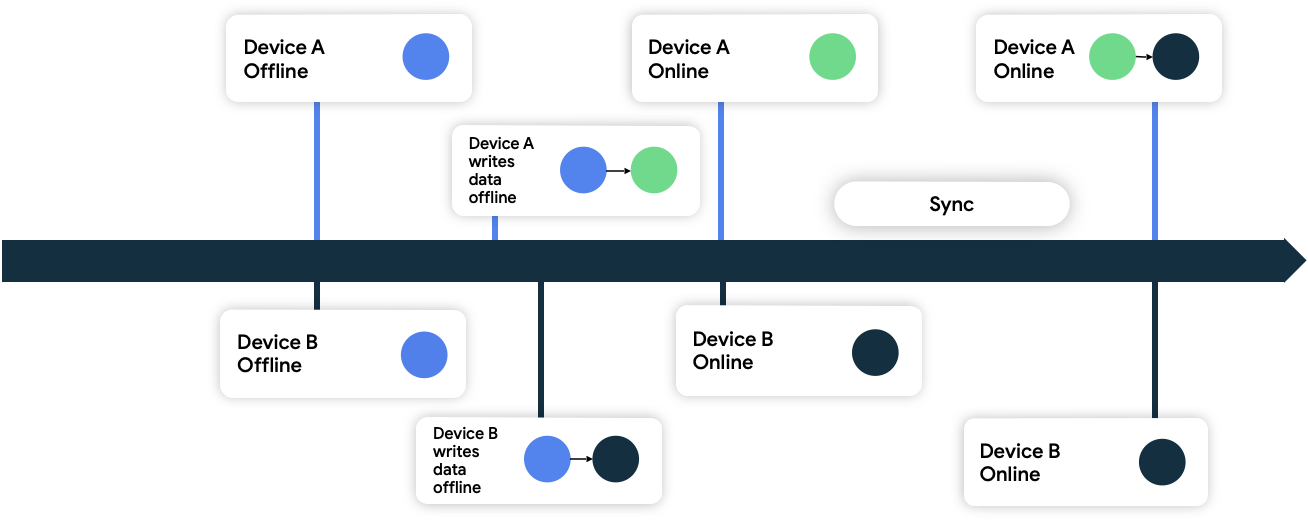
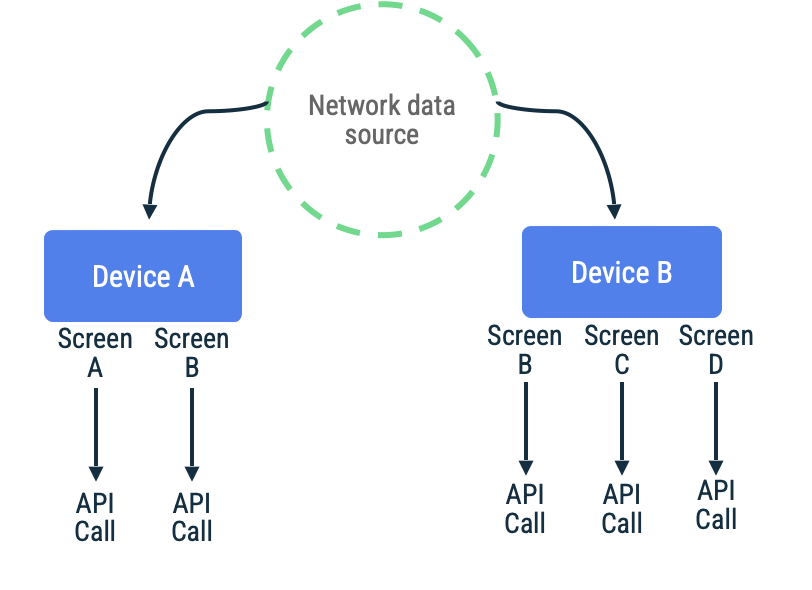
Na rysunku 9 oba urządzenia są offline i początkowo są zsynchronizowane ze źródłem danych sieci. W trybie offline obaj użytkownicy zapisują dane lokalnie i śledzą czas ich zapisu. Gdy oba urządzenia ponownie połączą się z internetem i zsynchronizują się ze źródłem danych sieci, sieć rozwiąże konflikt, zachowując dane z urządzenia B, ponieważ zostały zapisane później.
WorkManager w aplikacjach działających przede wszystkim offline
W obu omówionych wcześniej strategiach odczytu i zapisu występują 2 typowe narzędzia:
- Kolejki
- Odczyty: służy do odraczania odczytów do czasu, aż połączenie sieciowe będzie dostępne.
- Zapisy: służy do odraczania zapisów do momentu, gdy połączenie sieciowe będzie dostępne, oraz do ponownego umieszczania zapisów w kolejce w celu ponowienia próby.
- Monitory połączeń sieciowych
- Odczyty: używane jako sygnał do opróżnienia kolejki odczytu, gdy aplikacja jest połączona, oraz do synchronizacji.
- Zapisy: używane jako sygnał do opróżnienia kolejki zapisu, gdy aplikacja jest połączona, oraz do synchronizacji.
Oba przypadki są przykładami trwałej pracy, w której WorkManager sprawdza się doskonale.
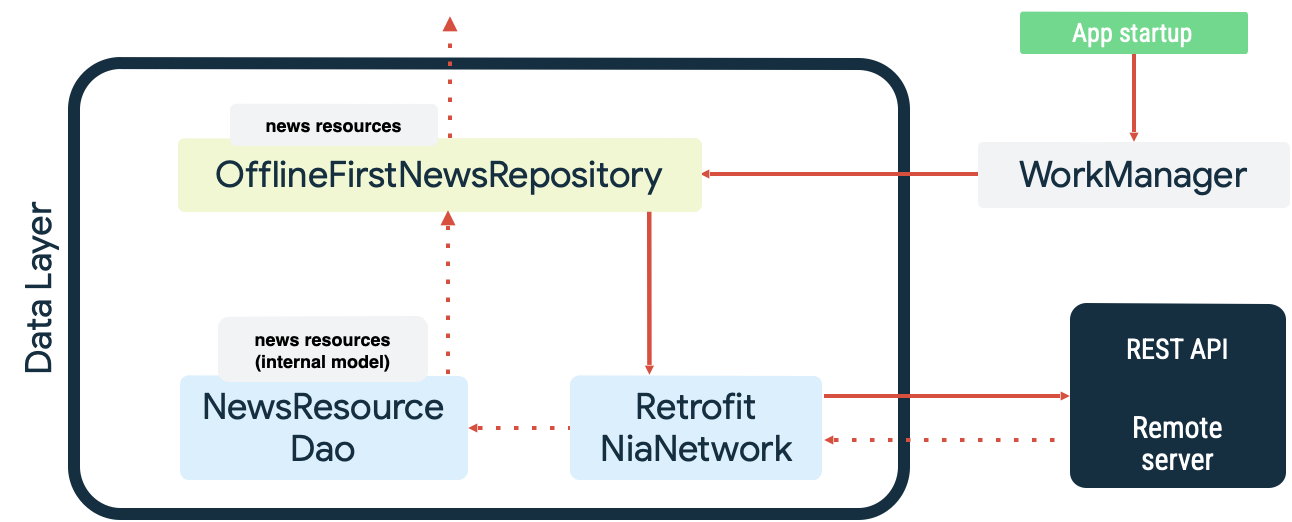
Na przykład w przykładowej aplikacji Now in Android WorkManager jest używany zarówno jako kolejka odczytu, jak i monitor sieci podczas synchronizowania danych produktów dostępnych lokalnie. Po uruchomieniu aplikacja wykonuje te czynności:
- Kolejkuje zadanie synchronizacji odczytu, aby zapewnić zgodność między danymi produktów dostępnych lokalnie a sieciowym źródłem danych.
- Opróżnia kolejkę synchronizacji odczytu i rozpoczyna synchronizację, gdy aplikacja jest online.
- Odczytuje dane ze źródła danych sieciowych, stosując wzrastający czas do ponowienia.
- Trwale przechowuje wyniki odczytu w lokalnym źródle danych produktów dostępnych lokalnie i rozwiązuje wszelkie konflikty, które wystąpią.
- Udostępnia dane produktów dostępnych lokalnie z lokalnego źródła danych innym warstwom aplikacji.
Te działania są przedstawione na tym diagramie:
Kolejkowanie zadania synchronizacji za pomocą WorkManagera następuje po określeniu go jako unikalnego zadania za pomocą KEEP ExistingWorkPolicy:
class SyncInitializer : Initializer<Sync> {
   override fun create(context: Context): Sync {
       WorkManager.getInstance(context).apply {
           // Queue sync on app startup and ensure only one
           // sync worker runs at any time
           enqueueUniqueWork(
               SyncWorkName,
               ExistingWorkPolicy.KEEP,
               SyncWorker.startUpSyncWork()
           )
       }
       return Sync
   }
}
SyncWorker.startupSyncWork() jest zdefiniowany w ten sposób:
/**
 Create a WorkRequest to call the SyncWorker using a DelegatingWorker.
 This allows for dependency injection into the SyncWorker in a different
 module than the app module without having to create a custom WorkManager
 configuration.
*/
fun startUpSyncWork() = OneTimeWorkRequestBuilder<DelegatingWorker>()
    // Run sync as expedited work if the app is able to.
    // If not, it runs as regular work.
   .setExpedited(OutOfQuotaPolicy.RUN_AS_NON_EXPEDITED_WORK_REQUEST)
   .setConstraints(SyncConstraints)
    // Delegate to the SyncWorker.
   .setInputData(SyncWorker::class.delegatedData())
   .build()

val SyncConstraints
   get() = Constraints.Builder()
       .setRequiredNetworkType(NetworkType.CONNECTED)
       .build()
Konkretnie: Constraints zdefiniowane przez SyncConstraints wymagają, aby NetworkType miało wartość NetworkType.CONNECTED. Oznacza to, że przed uruchomieniem czeka, aż sieć będzie dostępna.
Gdy sieć jest dostępna, instancja robocza opróżnia unikalną kolejkę zadań określoną przez SyncWorkName, przekazując zadania do odpowiednich instancji Repository. Jeśli synchronizacja się nie powiedzie, metoda doWork() zwraca Result.retry(). WorkManager automatycznie ponowi synchronizację ze wzrastającym czasem do ponowienia. W przeciwnym razie zwraca wartość Result.success(), kończąc synchronizację.
class SyncWorker(...) : CoroutineWorker(appContext, workerParams), Synchronizer {

    override suspend fun doWork(): Result = withContext(ioDispatcher) {
        // First sync the repositories in parallel
        val syncedSuccessfully = awaitAll(
            async { topicRepository.sync() },
            async { authorsRepository.sync() },
            async { newsRepository.sync() },
        ).all { it }

        if (syncedSuccessfully) Result.success()
        else Result.retry()
    }
}
Przykłady
Poniższe przykłady Google pokazują aplikacje działające przede wszystkim offline. Zapoznaj się z nimi, aby zobaczyć, jak te wskazówki wyglądają w praktyce:
Polecane dla Ciebie
- Uwaga: tekst linku jest wyświetlany, gdy język JavaScript jest wyłączony.
- Produkcja stanu w interfejsie
- Warstwa interfejsu
- Warstwa danych