

Un'app offline-first è un'app in grado di eseguire tutte o un sottoinsieme critico delle sue funzionalità di base senza accesso a internet. In altre parole, può eseguire parte o tutta la logica di business offline.
Le considerazioni per la creazione di un'app offline-first iniziano nel livello dati, che offre l'accesso ai dati dell'applicazione e alla logica di business. Di tanto in tanto, l'app potrebbe dover aggiornare questi dati da fonti esterne al dispositivo. In questo modo, potrebbe essere necessario chiamare le risorse di rete per rimanere aggiornati.
La disponibilità della rete non è sempre garantita. I dispositivi hanno spesso periodi di connessione di rete instabile o lenta. Gli utenti potrebbero riscontrare quanto segue:
- Larghezza di banda internet limitata
- Interruzioni temporanee della connessione, ad esempio quando ci si trova in un ascensore o in un tunnel
- Accesso occasionale ai dati, ad esempio tablet solo Wi-Fi
Indipendentemente dal motivo, spesso è possibile che un'app funzioni adeguatamente in queste circostanze. Per garantire il corretto funzionamento offline, l'app deve essere in grado di:
- Rimanere utilizzabile senza una connessione di rete affidabile
- Presentare immediatamente agli utenti i dati locali anziché attendere il completamento o l'esito negativo della prima chiamata di rete
- Recupera i dati in modo da tenere conto dello stato della batteria e dei dati, ad esempio richiedendo il recupero dei dati solo in condizioni ottimali, come durante la ricarica o con il Wi-Fi.
Un'app che soddisfa questi criteri viene spesso chiamata app offline-first.
Progetta un'app offline-first
Quando progetti un'app offline-first, inizia dal livello dati e dalle due operazioni principali che puoi eseguire sui dati dell'app:
- Letture: recupero dei dati per l'utilizzo da parte di altre sezioni dell'app, ad esempio per mostrare informazioni all'utente. In Compose, in genere questo risultato si ottiene osservando lo stato. Quando la UI osserva l'origine dati locale come stato, lo schermo riflette automaticamente i dati locali più recenti.
- Scritture: persistenza dell'input utente per un recupero successivo. In Compose, in genere questo risultato si ottiene utilizzando eventi e azioni inviati dalla UI al ViewModel.
I repository nel livello dati sono responsabili della combinazione delle origini dati per fornire i dati dell'app. In un'app offline-first, deve essere presente almeno un'origine dati che non richiede l'accesso alla rete per eseguire le attività più importanti. Una di queste attività critiche è la lettura dei dati.
Modella i dati in un'app offline-first
Un'app offline-first ha almeno due origini dati per ogni repository che utilizza risorse di rete:
- L'origine dati locale
- L'origine dati della rete
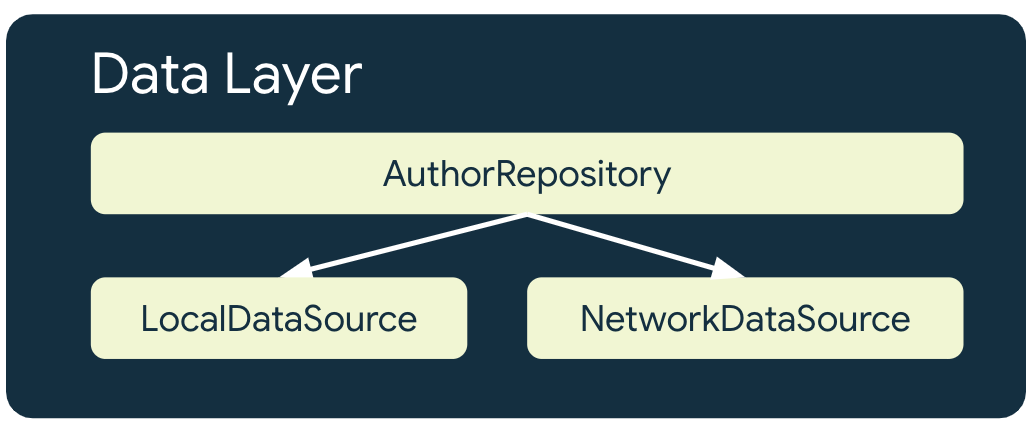
L'origine dati locale
L'origine dati locale è la fonte di riferimento canonica per l'app. Dovrebbe essere l'origine esclusiva di tutti i dati letti dai livelli superiori dell'app. In questo modo, viene garantita la coerenza dei dati tra gli stati di connessione. L'origine dati locale è spesso supportata da uno spazio di archiviazione che viene reso persistente su disco. Ecco alcuni metodi comuni per la persistenza dei dati su disco:
- Origini dati strutturate, come database relazionali come Room
- Origini dati non strutturate, ad esempio buffer di protocollo con DataStore
- File semplici
L'origine dati della rete
L'origine dati di rete è lo stato effettivo dell'applicazione. Nella migliore delle ipotesi, l'origine dati locale è sincronizzata con l'origine dati di rete. L'origine dati locale può anche essere in ritardo rispetto all'origine dati di rete. In questo caso, l'app deve essere aggiornata quando torna online. Al contrario, l'origine dati di rete potrebbe essere in ritardo rispetto all'origine dati locale finché l'app non può aggiornarla quando la connettività viene ripristinata. I livelli di dominio e UI dell'app non devono mai comunicare direttamente con il livello di rete. È responsabilità dell'repository di hosting comunicare con l'app e utilizzarla per aggiornare l'origine dati locale.
Sincronizzazione personalizzata e sincronizzazione gestita
La creazione di un livello dati offline-first può essere affrontata in due modi principali:
- Stack di sincronizzazione personalizzato: gestisci i database locali con Room o i file nello spazio di archiviazione locale, crei client di rete personalizzati e pianifichi i worker di riconciliazione con WorkManager. Questo approccio offre il massimo controllo su schemi e algoritmi di risoluzione dei conflitti personalizzati.
- Servizi cloud gestiti: soluzioni come Cloud Firestore possono fornire una cache locale all-in-one e uno stream cloud in tempo reale. L'SDK gestisce automaticamente la memorizzazione nella cache del disco, la coda di scrittura offline e la sincronizzazione bidirezionale, fornendo flussi di dati in tempo reale direttamente al tuo repository. Per i backend PostgreSQL relazionali, Firebase SQL Connect genera SDK client Kotlin con sicurezza dei tipi che si integrano perfettamente con i tuoi repository. Per i dati non strutturati (come contenuti multimediali, file di grandi dimensioni o backup), Cloud Storage for Firebase fornisce l'archiviazione di oggetti ospitata nel cloud con operazioni di caricamento e download che vengono messe in pausa e riprese automaticamente in caso di interruzioni della rete.
Esposizione delle risorse
Le origini dati locali e di rete possono differire fondamentalmente nel modo in cui la tua app può leggere e scrivere su di esse. L'esecuzione di query su un'origine dati locale può essere rapida e flessibile, ad esempio quando si utilizzano query SQL. Al contrario, le origini dati di rete possono essere lente e limitate, ad esempio quando si accede in modo incrementale alle risorse RESTful tramite ID. Di conseguenza, ogni origine dati spesso richiede una propria rappresentazione dei dati che fornisce. L'origine dati locale e l'origine dati di rete potrebbero quindi avere i propri modelli.
La seguente struttura di directory aiuta a visualizzare questo concetto. AuthorEntity rappresenta un autore letto dal database locale dell'app, mentre NetworkAuthor rappresenta un autore serializzato sulla rete:
data/
├─ local/
│ ├─ entities/
│ │ ├─ AuthorEntity
│ ├─ dao/
│ ├─ NiADatabase
├─ network/
│ ├─ NiANetwork
│ ├─ models/
│ │ ├─ NetworkAuthor
├─ model/
│ ├─ Author
├─ repository/
Di seguito sono riportati i dettagli di AuthorEntity e NetworkAuthor:
/**
 * Network representation of [Author]
 */
@Serializable
data class NetworkAuthor(
    val id: String,
    val name: String,
    val imageUrl: String,
    val twitter: String,
    val mediumPage: String,
    val bio: String,
)

/**
 * Defines an author for either an [EpisodeEntity] or [NewsResourceEntity].
 * It has a many-to-many relationship with both entities
 */
@Entity(tableName = "authors")
data class AuthorEntity(
    @PrimaryKey
    val id: String,
    val name: String,
    @ColumnInfo(name = "image_url")
    val imageUrl: String,
    @ColumnInfo(defaultValue = "")
    val twitter: String,
    @ColumnInfo(name = "medium_page", defaultValue = "")
    val mediumPage: String,
    @ColumnInfo(defaultValue = "")
    val bio: String,
)
È buona norma mantenere sia AuthorEntity che NetworkAuthor
all'interno del livello dati ed esporre un terzo tipo per i livelli esterni da
utilizzare. In questo modo, gli strati esterni sono protetti da modifiche minori nelle origini dati locali e di rete che non cambiano fondamentalmente il comportamento dell'app.
Questo è dimostrato nel seguente snippet:
/**
 * External data layer representation of a "Now in Android" Author
 */
data class Author(
    val id: String,
    val name: String,
    val imageUrl: String,
    val twitter: String,
    val mediumPage: String,
    val bio: String,
)
Il modello di rete può quindi definire un metodo di estensione per convertirlo nel modello locale e, analogamente, il modello locale ne ha uno per convertirlo nella rappresentazione esterna, come mostrato nel seguente snippet:
/**
 * Converts the network model to the local model for persisting
 * by the local data source
 */
fun NetworkAuthor.asEntity() = AuthorEntity(
    id = id,
    name = name,
    imageUrl = imageUrl,
    twitter = twitter,
    mediumPage = mediumPage,
    bio = bio,
)

/**
 * Converts the local model to the external model for use
 * by layers external to the data layer
 */
fun AuthorEntity.asExternalModel() = Author(
    id = id,
    name = name,
    imageUrl = imageUrl,
    twitter = twitter,
    mediumPage = mediumPage,
    bio = bio,
)
Letture
Le letture sono l'operazione fondamentale sui dati dell'app in un'app offline-first. Devi quindi assicurarti che la tua app possa leggere i dati e che, non appena sono disponibili nuovi dati, l'app possa visualizzarli. Un'app che può farlo è un'app reattiva perché espone API di lettura con tipi osservabili.
Nello snippet seguente, OfflineFirstTopicRepository restituisce Flow per tutte le sue API di lettura. In questo modo, può aggiornare i lettori quando riceve aggiornamenti dall'origine dati di rete. In altre parole, consente a OfflineFirstTopicRepository di eseguire il push delle modifiche quando l'origine dati locale viene invalidata. Pertanto, ogni lettore di OfflineFirstTopicRepository deve essere preparato a gestire le modifiche ai dati che possono essere attivate quando viene ripristinata la connessione di rete all'app. Inoltre, OfflineFirstTopicRepository legge i dati direttamente dall'origine dati locale. Può solo notificare ai lettori le modifiche ai dati aggiornando prima l'origine dati locale.
class TopicsViewModel(
    offlineFirstTopicsRepository: OfflineFirstTopicsRepository
) : ViewModel() {

    val topics: StateFlow<List<Topic>> = offlineFirstTopicsRepository.getTopicsStream()
        .stateIn(
            scope = viewModelScope,
            started = SharingStarted.WhileSubscribed(5_000),
            initialValue = emptyList()
        )
}
In un'app Jetpack Compose, utilizza un ViewModel per collegare il livello dati e l'interfaccia utente.
Nel ViewModel, converti Flow in StateFlow utilizzando l'operatore stateIn. I componibili raccolgono quindi questi stati utilizzando
collectAsStateWithLifecycle() e gestiscono automaticamente le iscrizioni in modo
sensibile al ciclo di vita.
Per saperne di più su collectAsStateWithLifecycle(), consulta Stato e Jetpack Compose.
Strategie di gestione degli errori
Esistono modi unici per gestire gli errori nelle app offline-first, a seconda delle origini dati in cui potrebbero verificarsi. Le sezioni seguenti descrivono queste strategie.
Origine dati locale
Cerca di ridurre al minimo gli errori durante la lettura dall'origine dati locale. Per proteggere i lettori dagli errori, utilizza l'operatore catch sui Flow da cui il lettore raccoglie i dati.
Puoi utilizzare l'operatore catch in un ViewModel come segue:
class AuthorViewModel(
    authorsRepository: AuthorsRepository,
    ...
) : ViewModel() {
   private val authorId: String = ...

   // Observe author information
    private val authorStream: Flow<Author> =
        authorsRepository.getAuthorStream(
            id = authorId
        )
        .catch { emit(Author.empty()) }
}
Per un approccio più resiliente, prendi in considerazione una soluzione LCE (Loading Content Error). In LCE, quando si verifica un errore durante la lettura, viene mostrato uno stato di errore. In genere, l'LCE si ottiene modellando gli stati della UI come classi sealed di Kotlin.
// Define the LCE UI state
sealed interface AuthorUiState {
    data object Loading : AuthorUiState
    data class Success(val author: Author) : AuthorUiState
    data object Error : AuthorUiState
}

class AuthorViewModel(
    authorsRepository: AuthorsRepository,
    ...
) : ViewModel() {
    private val authorId: String = ...

    // Observe author information and map to LCE state
    val authorUiState: StateFlow<AuthorUiState> =
        authorsRepository.getAuthorStream(id = authorId)
            .map<Author, AuthorUiState> { author ->
                AuthorUiState.Success(author)
            }
            .catch { emit(AuthorUiState.Error) }
            .stateIn(
                scope = viewModelScope,
                started = SharingStarted.WhileSubscribed(5_000),
                initialValue = AuthorUiState.Loading
            )
}
Origine dati di rete
Se si verificano errori durante la lettura dei dati da un'origine dati di rete, l'app deve utilizzare un'euristica per riprovare a recuperare i dati. Le euristiche più comuni includono:
Backoff esponenziale
Nel backoff esponenziale, l'app continua a tentare di leggere dall'origine dati di rete con intervalli di tempo crescenti fino a quando non riesce o altre condizioni impongono l'interruzione.
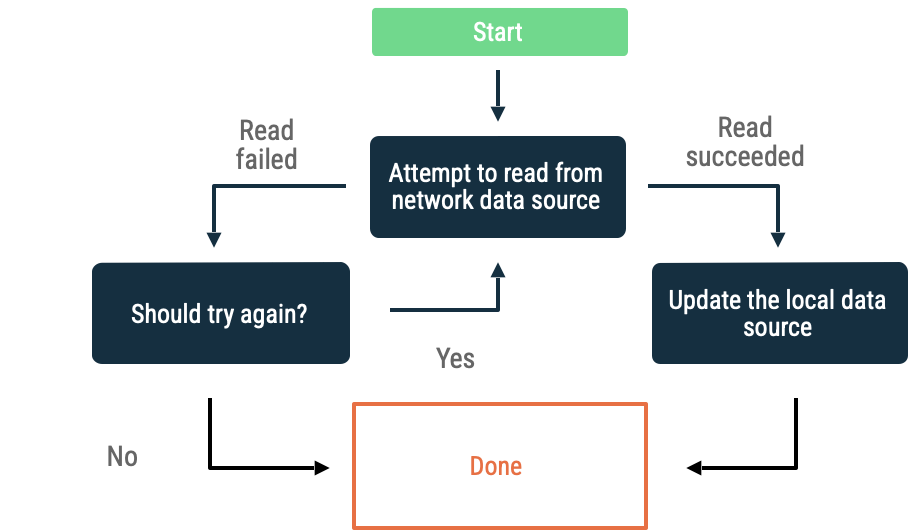
I criteri per valutare se l'app continua a ritirarsi includono:
- Il tipo di errore indicato dall'origine dati di rete. Ad esempio, riprova a effettuare chiamate di rete che restituiscono un errore che indica una mancanza di connettività. Non riprovare a inviare richieste HTTP non autorizzate finché non sono disponibili le credenziali appropriate.
- Numero massimo di nuovi tentativi consentiti.
Monitoraggio della connettività di rete
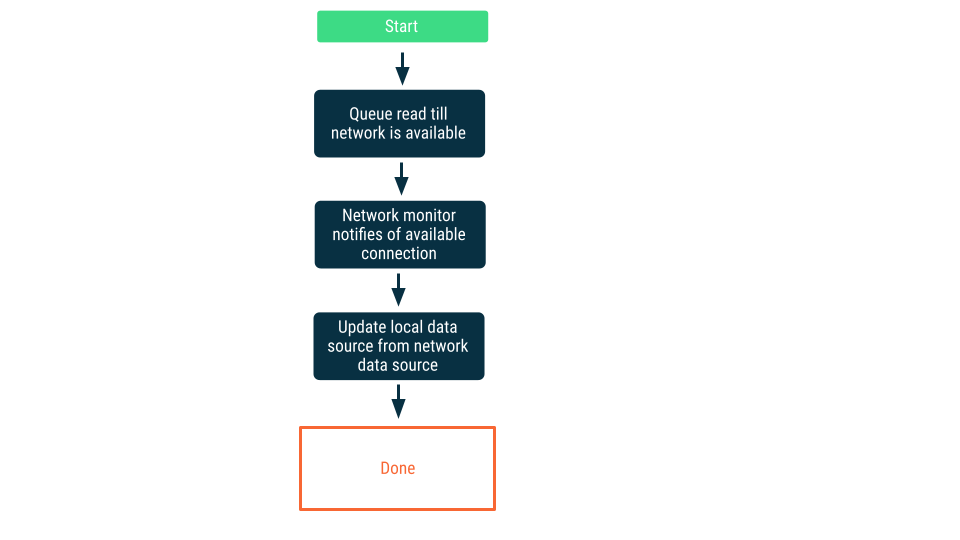
In questo approccio, le richieste di lettura vengono messe in coda finché l'app non è certa di potersi connettere all'origine dati di rete. Una volta stabilita una connessione, la richiesta di lettura viene rimossa dalla coda, i dati vengono letti e l'origine dati locale viene aggiornata. Su Android, questa coda potrebbe essere gestita con un database Room e svuotata come lavoro persistente utilizzando WorkManager.
Scritture
Sebbene il modo consigliato per leggere i dati in un'app offline-first sia utilizzare tipi osservabili, l'equivalente per le API di scrittura sono le API asincrone, come le funzioni di sospensione. In questo modo, eviti di bloccare il thread dell'interfaccia utente e semplifichi la gestione degli errori, poiché le scritture nelle app offline-first possono non riuscire quando si attraversa un confine di rete.
interface UserDataRepository {
    /**
     * Updates the bookmarked status for a news resource
     */
    suspend fun updateNewsResourceBookmark(newsResourceId: String, bookmarked: Boolean)
}
Nello snippet precedente, l'API asincrona scelta è Coroutines, poiché il metodo viene sospeso.
Strategie di scrittura
Quando scrivi dati in app offline-first, devi considerare tre strategie. La scelta dipende dal tipo di dati scritti e dai requisiti dell'app:
Scritture solo online
Tentativo di scrivere i dati oltre il perimetro della rete. Se l'operazione va a buon fine, aggiorna l'origine dati locale; in caso contrario, genera un'eccezione e lascia che sia il chiamante a rispondere in modo appropriato.
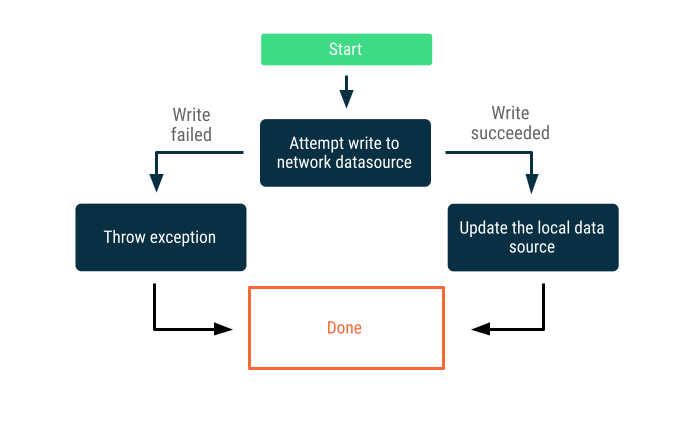
Questa strategia viene spesso utilizzata per le transazioni di scrittura che devono avvenire online quasi in tempo reale, ad esempio un bonifico bancario. Poiché le scritture possono non riuscire, spesso è necessario comunicare all'utente che la scrittura non è andata a buon fine o impedire all'utente di tentare di scrivere dati. Ecco alcune strategie che puoi adottare in questi scenari:
- Se un'app richiede l'accesso a internet per scrivere dati, puoi scegliere di non presentare all'utente un'interfaccia utente che gli consenta di scrivere dati o, almeno, puoi disattivarla.
- Puoi utilizzare un
AlertDialogche l'utente non può ignorare o unSnackbarper informare l'utente che è offline.
Scritture in coda
Quando hai un oggetto che vuoi scrivere, inseriscilo in una coda. Quando l'app torna online, svuota la coda con il backoff esponenziale. Su Android, lo svuotamento di una coda offline è un'attività persistente che viene spesso delegata a WorkManager.
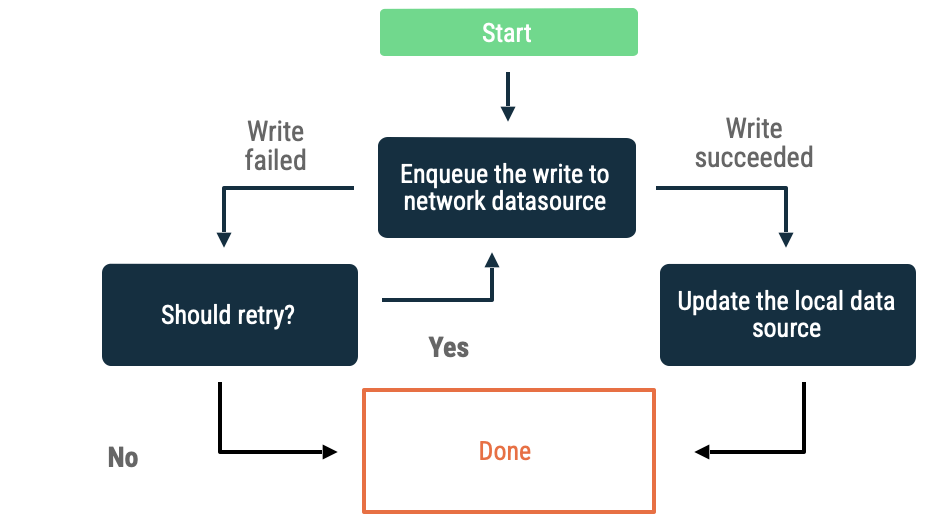
Questo approccio è una buona scelta nei seguenti scenari:
- Non è essenziale che i dati vengano scritti sulla rete.
- La transazione non è sensibile al fattore tempo.
- Non è essenziale che l'utente venga informato se l'operazione non va a buon fine.
I casi d'uso di questo approccio includono eventi di analisi e logging.
Scritture lazy
Scrivi prima nell'origine dati locale, poi metti in coda la scrittura per inviare una notifica alla rete alla prima occasione. Non è un'operazione semplice, perché possono verificarsi conflitti tra le origini dati di rete e i dati locali quando l'app torna online. La sezione successiva sulla risoluzione dei conflitti fornisce ulteriori dettagli.
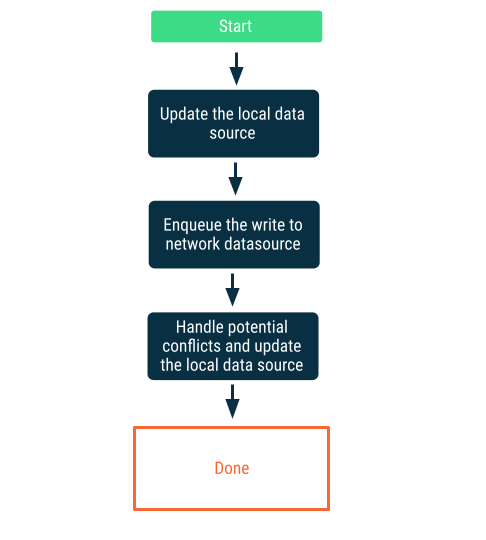
Questo approccio è la scelta corretta quando i dati sono fondamentali per l'app. Ad esempio, in un'app per l'elenco di cose da fare offline, è essenziale che tutte le attività aggiunte dall'utente offline vengano archiviate localmente per evitare il rischio di perdita di dati.
Sincronizzazione e risoluzione dei conflitti
Quando un'app offline-first ripristina la connettività, deve riconciliare i dati nell'origine dati locale con quelli nell'origine dati di rete. Questo processo è chiamato sincronizzazione. Esistono due modi principali in cui un'app può sincronizzarsi con la sua origine dati di rete:
- Sincronizzazione basata su pull
- Sincronizzazione basata su push
Sincronizzazione basata su pull
Nella sincronizzazione basata su pull, l'app si connette alla rete per leggere gli ultimi dati dell'applicazione on demand. Un'euristica comune per questo approccio è basata sulla navigazione, in cui l'app recupera i dati solo poco prima di presentarli all'utente.
Questo approccio funziona meglio quando l'app prevede periodi di assenza di connettività di rete di durata breve o intermedia. Questo perché l'aggiornamento dei dati è opportunistico e lunghi periodi di assenza di connettività aumentano la probabilità che l'utente tenti di visitare le destinazioni dell'app con una cache obsoleta o vuota.
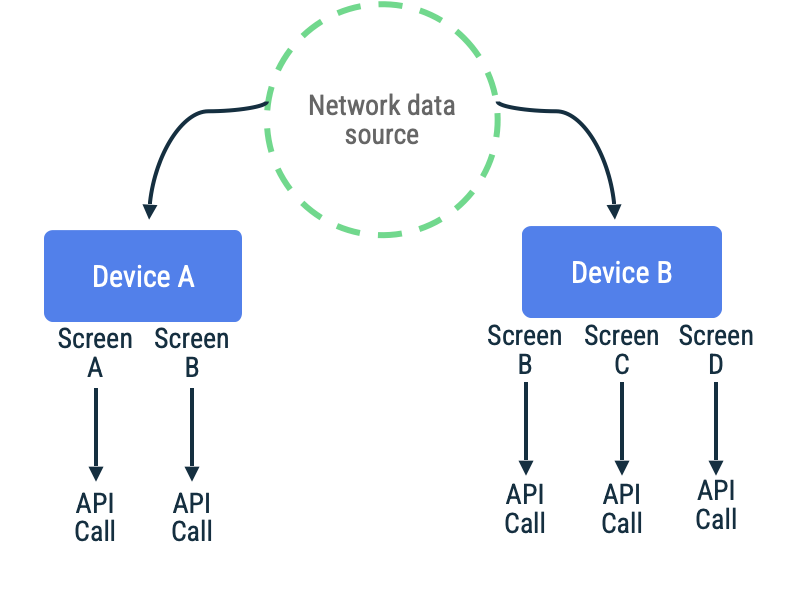
Prendi in considerazione un'app in cui i token di pagina vengono utilizzati per recuperare gli elementi in un elenco a scorrimento infinito per una determinata schermata. L'implementazione potrebbe contattare la rete in modo lazy, rendere persistenti i dati nell'origine dati locale e quindi leggere dall'origine dati locale per presentare le informazioni all'utente. Se non è presente una connessione di rete, il repository potrebbe richiedere i dati solo all'origine dati locale. Questo è il pattern utilizzato dalla libreria Jetpack Paging con la sua API RemoteMediator.
class FeedRepository(...) {

    fun feedPagingSource(): PagingSource<FeedItem> { ... }
}

class FeedViewModel(
    private val repository: FeedRepository
) : ViewModel() {
    private val pager = Pager(
        config = PagingConfig(
            pageSize = NETWORK_PAGE_SIZE,
            enablePlaceholders = false
        ),
        remoteMediator = FeedRemoteMediator(...),
        pagingSourceFactory = feedRepository::feedPagingSource
    )

    val feedPagingData = pager.flow
}
I vantaggi e gli svantaggi della sincronizzazione basata su pull sono riassunti nella tabella seguente:
| Vantaggi | Svantaggi |
|---|---|
| Relativamente facile da implementare. | Tendenza a un utilizzo intensivo dei dati. Questo perché le visite ripetute a una destinazione di navigazione attivano il recupero non necessario di informazioni invariate. Puoi mitigare questo problema con una memorizzazione nella cache adeguata. Questa operazione può essere eseguita nel livello UI con l'operatore cachedIn o nel livello di rete con una cache HTTP. |
| I dati non necessari non vengono mai recuperati. | Non si adatta bene ai dati relazionali perché il modello estratto deve essere autosufficiente. Se il modello sincronizzato dipende da altri modelli da recuperare per essere compilato, il problema dell'utilizzo intensivo dei dati menzionato in precedenza diventa ancora più significativo. Inoltre, può causare dipendenze tra i repository del modello principale e quelli del modello nidificato. |
Sincronizzazione basata su push
Nella sincronizzazione basata su push, l'origine dati locale tenta di simulare un set di repliche dell'origine dati di rete al meglio delle sue capacità. Recupera in modo proattivo una quantità appropriata di dati al primo avvio per impostare una base di riferimento. In seguito, si affida alle notifiche del server per ricevere avvisi quando i dati sono obsoleti.
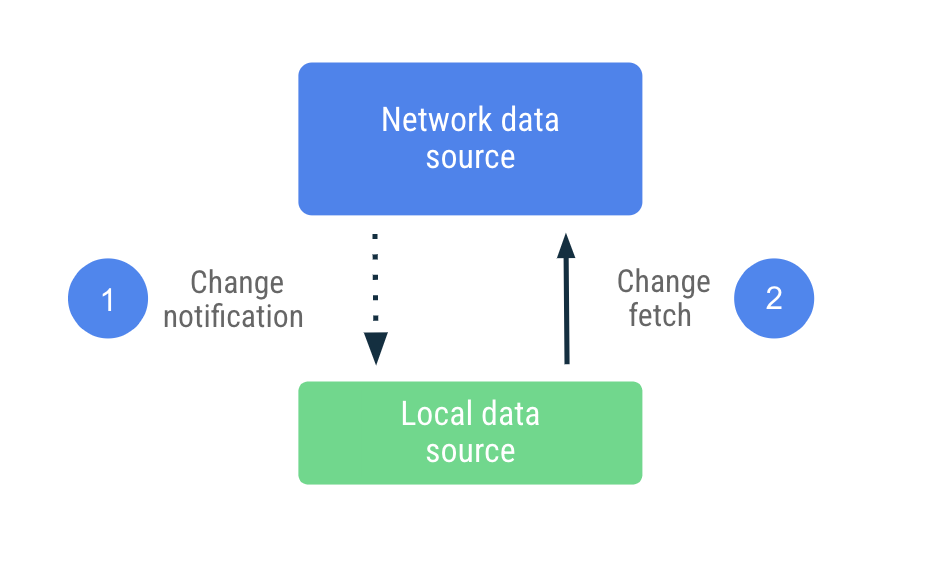
Al ricevimento della notifica di dati inattivi, l'app contatta la rete per aggiornare solo i dati contrassegnati come inattivi. Questo lavoro viene delegato a
Repository, che contatta l'origine dati di rete e conserva i dati
recuperati nell'origine dati locale. Poiché il repository espone i propri dati con tipi osservabili, i lettori vengono informati di eventuali modifiche.
class UserDataRepository(...) {

    suspend fun synchronize() {
        val userData = networkDataSource.fetchUserData()
        localDataSource.saveUserData(userData)
    }
}
In questo approccio, l'app dipende molto meno dall'origine dati di rete e può funzionare senza di essa per periodi prolungati. Offre l'accesso in lettura e scrittura quando è offline perché presuppone di avere localmente le informazioni più recenti dall'origine dati di rete.
I vantaggi e gli svantaggi della sincronizzazione basata su push sono riassunti nella seguente tabella:
| Vantaggi | Svantaggi |
|---|---|
| L'app può rimanere offline a tempo indeterminato. | Il controllo delle versioni dei dati per la risoluzione dei conflitti non è semplice. |
| Utilizzo minimo dei dati. L'app recupera solo i dati che sono stati modificati. | Durante la sincronizzazione, devi tenere conto dei problemi di scrittura. |
| Funziona bene per i dati relazionali. Ogni repository è responsabile del recupero dei dati solo per il modello che supporta. | L'origine dati della rete deve supportare la sincronizzazione. |
Sincronizzazione ibrida
Alcune app utilizzano un approccio ibrido basato su pull o push a seconda dei dati. Ad esempio, un'app di social media potrebbe utilizzare la sincronizzazione basata su pull per recuperare il feed degli utenti seguiti on demand a causa dell'elevata frequenza degli aggiornamenti del feed. La stessa app potrebbe scegliere di utilizzare la sincronizzazione basata su push per i dati relativi all'utente che ha eseguito l'accesso, inclusi il nome utente, l'immagine del profilo e così via.
In definitiva, la scelta della sincronizzazione offline-first dipende dai requisiti del prodotto e dall'infrastruttura tecnica disponibile.
Risoluzione dei conflitti
Se, quando è offline, l'app scrive localmente dati non allineati con l'origine dati di rete, devi risolvere il conflitto prima che possa avvenire la sincronizzazione.
La risoluzione dei conflitti spesso richiede il controllo delle versioni. L'app deve eseguire alcune operazioni di contabilità per tenere traccia di quando si sono verificate le modifiche, in modo da poter passare i metadati all'origine dati di rete. L'origine dati di rete ha quindi la responsabilità di fornire l'origine dati attendibile assoluta. Esistono molte strategie da considerare per la risoluzione dei conflitti, a seconda delle esigenze dell'applicazione. Per le app mobile, un approccio comune è "last write wins".
Last write wins
In questo approccio, i dispositivi collegano i metadati del timestamp ai dati che scrivono sulla rete. Quando l'origine dati di rete li riceve, ignora i dati precedenti allo stato attuale e accetta quelli successivi.
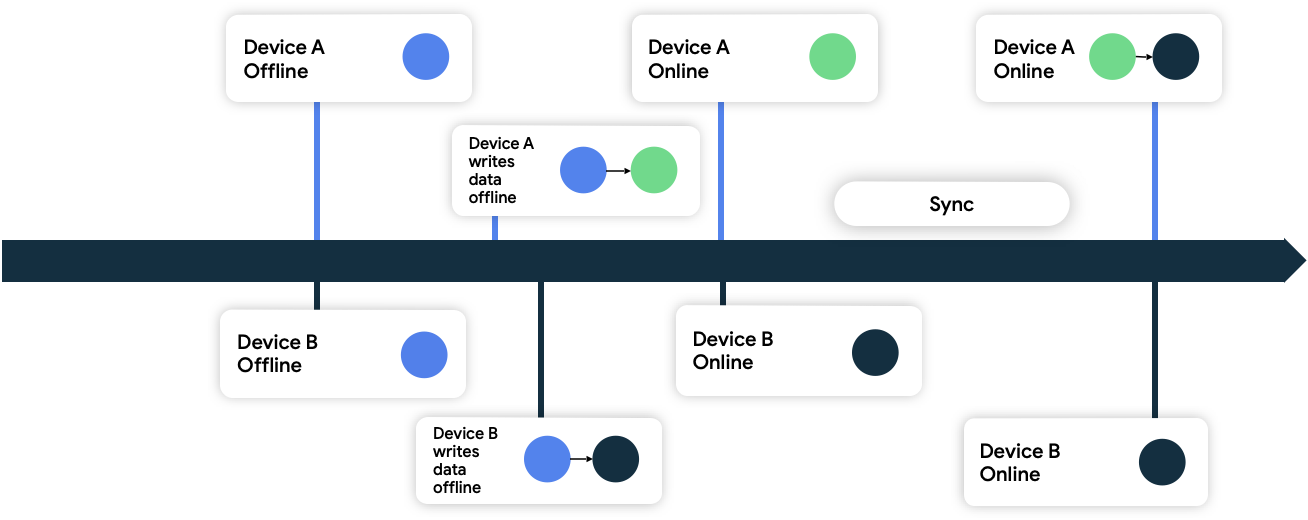
Nella Figura 9, entrambi i dispositivi sono offline e inizialmente sono sincronizzati con l'origine dati di rete. Mentre sono offline, entrambi scrivono i dati localmente e tengono traccia dell'ora in cui li hanno scritti. Quando entrambi tornano online e si sincronizzano con l'origine dati di rete, la rete risolve il conflitto mantenendo i dati del dispositivo B perché li ha scritti in un secondo momento.
WorkManager nelle app offline-first
Sia nelle strategie di lettura che in quelle di scrittura trattate in precedenza, esistono due utilità comuni:
- Code
- Letture: utilizzate per posticipare le letture finché non è disponibile la connessione di rete.
- Scritture: utilizzate per rinviare le scritture finché non è disponibile la connettività di rete e per rimettere in coda le scritture per i nuovi tentativi.
- Monitor di connettività di rete
- Letture: utilizzate come indicatore per svuotare la coda di lettura quando l'app è connessa e per la sincronizzazione.
- Scritture: utilizzate come indicatore per svuotare la coda di scrittura quando l'app è connessa e per la sincronizzazione.
Entrambi i casi sono esempi di lavoro persistente in cui WorkManager eccelle.
Ad esempio, nell'app di esempio Now in Android, WorkManager viene utilizzato sia come coda di lettura sia come monitor di rete durante la sincronizzazione dell'origine dati locale. All'avvio, l'app esegue le seguenti operazioni:
- Mette in coda il lavoro di sincronizzazione della lettura per garantire la parità tra l'origine dati locale e l'origine dati di rete.
- Svuota la coda di sincronizzazione in lettura e avvia la sincronizzazione quando l'app è online.
- Esegue una lettura dall'origine dati di rete utilizzando il backoff esponenziale.
- Conserva i risultati della lettura nell'origine dati locale e risolve eventuali conflitti che si verificano.
- Espone i dati dell'origine dati locale per l'utilizzo da parte di altri livelli dell'app.
Queste azioni sono illustrate nel seguente diagramma:
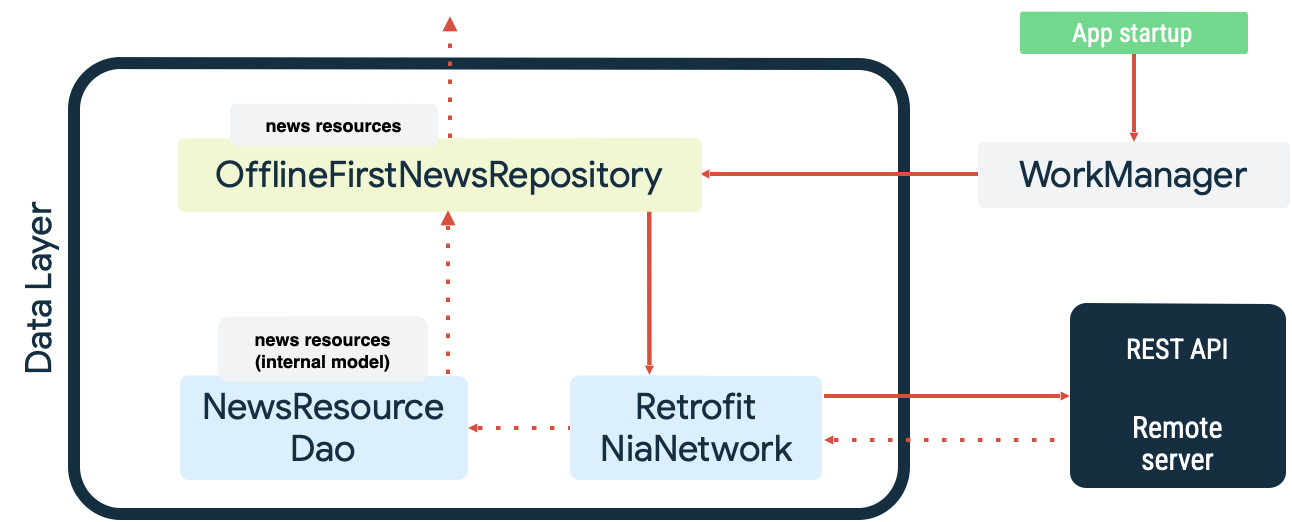
L'inserimento in coda del lavoro di sincronizzazione con WorkManager segue specificandolo come lavoro univoco con KEEP ExistingWorkPolicy:
class SyncInitializer : Initializer<Sync> {
   override fun create(context: Context): Sync {
       WorkManager.getInstance(context).apply {
           // Queue sync on app startup and ensure only one
           // sync worker runs at any time
           enqueueUniqueWork(
               SyncWorkName,
               ExistingWorkPolicy.KEEP,
               SyncWorker.startUpSyncWork()
           )
       }
       return Sync
   }
}
SyncWorker.startupSyncWork() è definito come segue:
/**
 Create a WorkRequest to call the SyncWorker using a DelegatingWorker.
 This allows for dependency injection into the SyncWorker in a different
 module than the app module without having to create a custom WorkManager
 configuration.
*/
fun startUpSyncWork() = OneTimeWorkRequestBuilder<DelegatingWorker>()
    // Run sync as expedited work if the app is able to.
    // If not, it runs as regular work.
   .setExpedited(OutOfQuotaPolicy.RUN_AS_NON_EXPEDITED_WORK_REQUEST)
   .setConstraints(SyncConstraints)
    // Delegate to the SyncWorker.
   .setInputData(SyncWorker::class.delegatedData())
   .build()

val SyncConstraints
   get() = Constraints.Builder()
       .setRequiredNetworkType(NetworkType.CONNECTED)
       .build()
In particolare, i Constraints definiti da SyncConstraints richiedono che
NetworkType sia NetworkType.CONNECTED. In altre parole, attende che la rete sia disponibile prima di essere eseguito.
Una volta che la rete è disponibile, il Worker svuota la coda di lavoro univoca specificata da SyncWorkName delegando alle istanze Repository appropriate. Se la sincronizzazione non va a buon fine, il metodo doWork() restituisce
Result.retry(). WorkManager riproverà automaticamente la sincronizzazione con il backoff esponenziale. In caso contrario, restituisce Result.success(), completando la sincronizzazione.
class SyncWorker(...) : CoroutineWorker(appContext, workerParams), Synchronizer {

    override suspend fun doWork(): Result = withContext(ioDispatcher) {
        // First sync the repositories in parallel
        val syncedSuccessfully = awaitAll(
            async { topicRepository.sync() },
            async { authorsRepository.sync() },
            async { newsRepository.sync() },
        ).all { it }

        if (syncedSuccessfully) Result.success()
        else Result.retry()
    }
}
Esempi
I seguenti esempi di Google mostrano app offline-first. Esplorali per vedere queste indicazioni in pratica:
Consigliati per te
- Nota: il testo del link viene visualizzato quando JavaScript è disattivato
- Produzione stato UI
- Livello UI
- Livello dati